Transformer & Self-Attention: Bangun Encoder dari Nol, Lalu Ketahuan Overfitting

Minggu ini masuk ke salah satu bagian paling penting dari NLP modern: Transformer dan mekanisme self-attention di baliknya. Tapi alih-alih cuma jelasin teorinya, aku coba praktikkan langsung — bangun Transformer Encoder dari nol buat klasifikasi intent teks berbahasa Indonesia. Hasilnya nggak semulus yang dibayangkan: model awal langsung overfitting, dan justru itu jadi bagian paling menarik dari tulisan ini.
Daftar Isi
Coba Tebak Dulu
Sebelum lanjut baca: kalau kamu latih Transformer Encoder 6-layer (jutaan parameter) dari nol, cuma pakai 75 kalimat data latih, selama 20 epoch tetap tanpa validation split — kira-kira apa yang terjadi ke training loss-nya?
A) Turun pelan dan stabil di angka wajar
B) Turun drastis ke hampir nol jauh sebelum epoch-nya habis
C) Malah naik karena modelnya kekecilan
Jawabannya ada di bagian "Plot Twist" di bawah.
Apa Itu Transformer & Self-Attention
Transformer adalah arsitektur yang dirancang buat menangani data berurutan seperti teks, tanpa harus memprosesnya kata demi kata seperti RNN atau LSTM. Diperkenalkan lewat paper "Attention Is All You Need" (Vaswani dkk., 2017), inti dari Transformer ada di mekanisme self-attention: setiap kata dalam kalimat bisa langsung "melihat" kata lain di posisi mana pun untuk memahami konteks.
Tiga komponen kunci di balik self-attention:
Query (Q) — representasi kata yang sedang diproses
Key (K) — representasi kata lain dalam urutan
Value (V) — isi atau konteks dari kata-kata lain
Karena semua token diproses sekaligus (bukan satu per satu), Transformer butuh Positional Encoding supaya tetap tahu urutan kata. Biasanya dipakai formula sinusoidal (sin/cos) yang memberi tiap posisi "sidik jari" numerik yang unik. Lalu Multi-Head Attention menjalankan beberapa proses attention ini secara paralel, supaya model menangkap berbagai jenis hubungan antar kata dalam satu waktu.
Proyek: Intent Classifier Bahasa Indonesia
Untuk mempraktikkan konsep di atas, aku bangun sebuah intent classifier — model yang menebak maksud dari kalimat pendek, di antara tiga kategori: greeting (sapaan), sekarang_jam_berapa (nanya waktu), dan siapa_anda (nanya identitas).
Arsitekturnya: TransformerClassifier encoder-only, memakai nn.TransformerEncoder bawaan PyTorch (yang di dalamnya sudah mengimplementasikan multi-head self-attention, feed-forward network, dan residual connection) di atas embedding dari tokenizer BERT Bahasa Indonesia (cahya/bert-base-indonesian-522M).
Plot Twist: Overfitting Ketauan
Training pertama kelihatan "berhasil" — loss-nya turun terus. Tapi begitu dilihat lebih detail, ada yang janggal:
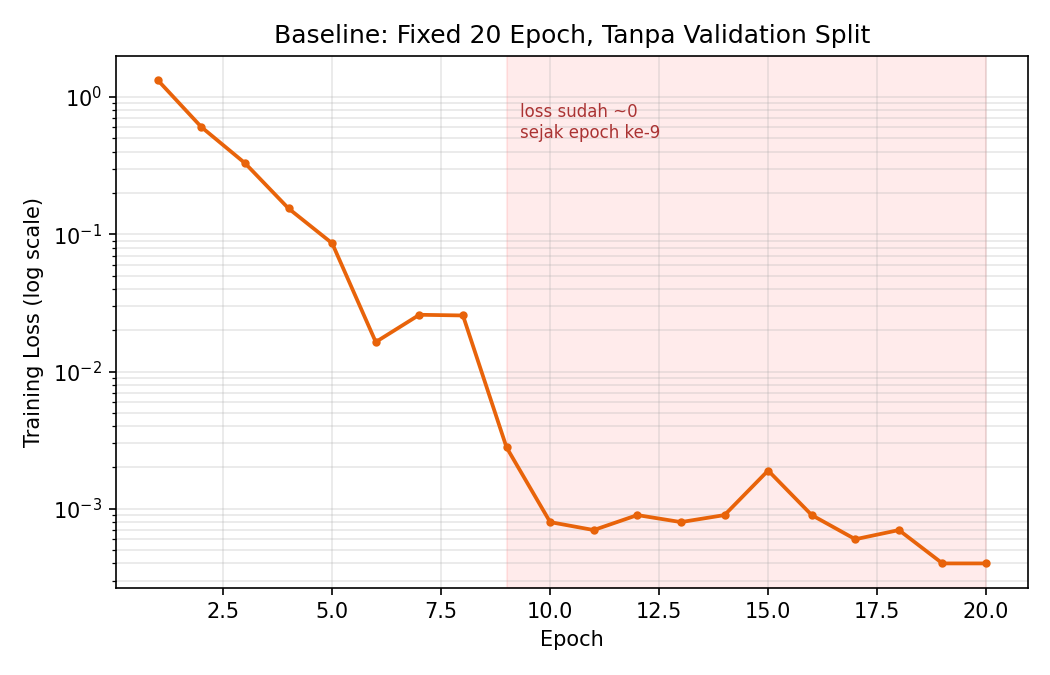
Loss-nya turun ke hampir nol sejak epoch ke-9 dari 20 — jawaban "Coba Tebak Dulu" di atas adalah B. Ini bukan tanda model belajar dengan baik, ini tanda model menghafal training set-nya. Masuk akal juga: Transformer 6-layer dengan hidden dimension 768 itu jutaan parameter, dilatih cuma dari 75 kalimat, tanpa validation split yang bisa kasih tahu kapan harus berhenti.
Jadi aku audit sistem aku sendiri: apa penyebabnya, dan gimana cara membenahinya?
Investigasi & Perbaikan
Tiga hal dicoba sekaligus:
Validation split + early stopping — training berhenti begitu validation loss berhenti membaik, bukan di epoch tetap
Model yang lebih kecil (
scratch_small: 2 layer, hidden 128, dropout & weight decay lebih tinggi) — untuk menguji apakah regularisasi saja sudah cukupTransfer learning beneran (
finetuned_bert) — fine-tune bobot BERT Indonesia yang sudah pretrained, bukan cuma memakai tokenizer-nya
Supaya hasilnya tidak bergantung pada satu split data yang kebetulan mudah atau sulit, ketiga varian dibandingkan pakai 5-fold Stratified Cross-Validation:
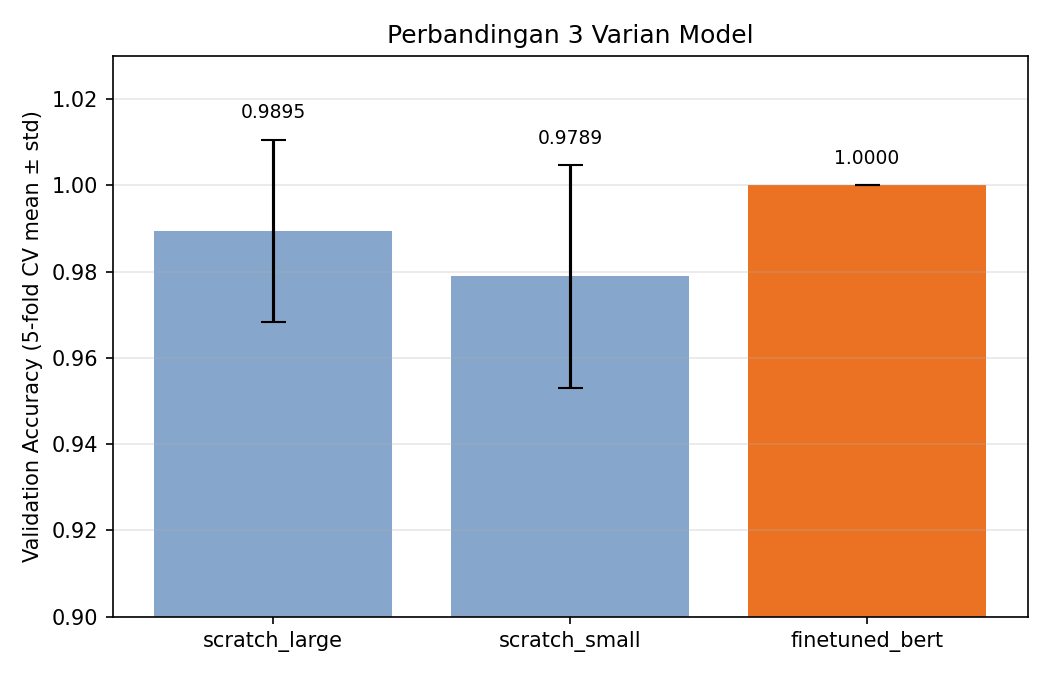
| Varian | CV Accuracy (mean ± std) |
|---|---|
| scratch_large (baseline, diperbaiki) | 0,9895 ± 0,0211 |
| scratch_small | 0,9789 ± 0,0258 |
| finetuned_bert | 1,0000 ± 0,0000 |
Early stopping dan validation split kelihatan berdampak: model scratch_large dengan arsitektur yang sama persis, begitu cara trainingnya diubah (validation split + early stopping) dan dievaluasi lewat rata-rata 5 fold (bukan cuma satu split), akurasinya naik dari sekitar 89–95% (single split) ke rata-rata CV 98,95%. Perlu dicatat, sebagian kenaikan ini juga berasal dari cara mengukurnya — rata-rata 5 fold secara alami lebih stabil dibanding satu split kecil, jadi ini bukan perbandingan yang sepenuhnya terisolasi ke satu variabel. Yang lebih jelas kelihatan adalah finetuned_bert: unggul konsisten dengan variance nol di semua fold — sejalan dengan hipotesis bahwa representasi bahasa yang sudah dipelajari sebelumnya butuh lebih sedikit data untuk generalisasi.
Kenapa Semua Model Jadi Nyaris Sempurna?
Ini bagian yang paling penting untuk disampaikan jujur. Ketiga varian sama-sama mendapat skor di atas 97%, termasuk model yang sengaja dikecilkan. Itu mencurigakan.
Jadi datasetnya dicek langsung. Ternyata: overlap kosakata antar tiga kelas cuma 8–10% (Jaccard similarity), dan kata-kata yang overlap itu kebanyakan kata fungsi umum ("ada", "bisa", "ini", "yang", "kamu", "apa") — bukan kata kunci yang jadi ciri khas topik. Kata konten tiap kelas (jam/waktu/pukul vs siapa/nama/dirimu vs hi/halo/selamat) nyaris tidak beririsan sama sekali. Tidak ada duplikasi data juga.
Artinya, task ini secara alami mudah dipisahkan secara leksikal — bukan bug, bukan data leakage, tapi karakteristik dataset yang kecil dan sederhana. Hasil ini bukti valid bahwa metodologinya (cross-validation, early stopping, transfer learning) bekerja dengan benar, bukan klaim bahwa modelnya "hebat" secara umum. Dataset yang lebih besar dan ambigu kemungkinan akan menunjukkan perbedaan yang lebih jelas antar ketiga model.
Quiz
1. Kenapa Transformer butuh Positional Encoding, sementara RNN tidak? a) Transformer tidak punya cukup parameter b) Transformer memproses semua token sekaligus, jadi tidak otomatis tahu urutannya c) Positional Encoding cuma untuk mempercepat training
Jawaban: b — RNN memproses token secara berurutan sehingga urutan implisit dari cara kerjanya, sementara Transformer memproses semua sekaligus sehingga butuh informasi posisi eksplisit.
2. Di eksperimen di atas, kenapa scratch_large bisa naik dari sekitar 89% ke 98,95% padahal arsitekturnya sama persis? a) Karena datanya ditambah b) Karena cara training-nya diperbaiki (validation split + early stopping), bukan arsitekturnya c) Karena modelnya direstart dari awal
Jawaban: b — arsitekturnya tidak berubah sama sekali. Yang berubah adalah cara training (validation split + early stopping) sekaligus cara evaluasi (rata-rata 5 fold, bukan satu split). Ini menunjukkan masalah awal memang lebih ke soal strategi training, meskipun sebagian kenaikan angkanya juga dipengaruhi cara pengukuran yang lebih stabil.
3. Kenapa skor yang nyaris sempurna di semua varian model justru perlu dicurigai, bukan langsung dirayakan? a) Karena itu artinya kodenya pasti ada bug b) Karena itu bisa jadi tanda task atau dataset-nya terlalu mudah atau kecil, bukan bukti model yang benar-benar hebat c) Karena akurasi di atas 95% selalu tidak valid
Jawaban: b — skor sempurna di dataset kecil dan sederhana tidak otomatis membuktikan generalisasi yang baik; konteksnya perlu dicek dulu.
Ringkasan
[x] Transformer memakai self-attention (Query/Key/Value) untuk memahami konteks antar kata secara global
[x] Positional Encoding (sinusoidal) dibutuhkan karena Transformer tidak memproses token secara berurutan
[x] Training tanpa validation split dan early stopping rawan overfitting, bahkan di dataset kecil
[x] 5-fold Cross-Validation memberi estimasi performa yang jauh lebih stabil dibanding satu split
[x] Transfer learning (fine-tuned BERT) menang di eksperimen ini, tapi skor nyaris sempurna di semua varian tetap perlu dicek konteks dataset-nya, bukan langsung dipercaya begitu saja
Kode lengkap, notebook, dan hasil eksperimennya ada di GitHub: transformer-self-attention-intent-classifier