Ngajarin Komputer "Melihat": Panduan Lengkap Image Classification dengan CNN & PyTorch
Ada aplikasi belanja yang bisa langsung mengenali jenis sayur dari foto. Kamera diarahkan ke jahe, lengkuas, atau kunyit, tiga bahan yang sering tertukar di pasar, dan aplikasinya langsung menjawab. Di balik itu semua ada satu konsep: image classification.
Artikel ini membongkar konsepnya dari nol: mulai dari apa itu piksel, sampai model CNN siap dilatih dengan PyTorch.
💡 Cara baca artikel ini: ada beberapa kotak "Coba Tebak Dulu" di sepanjang tulisan. Tebak dulu sebelum lihat jawabannya, biar lebih nempel.
Daftar Isi
Apa Itu Image Classification, Sebenarnya?
Definisinya sederhana. Kasih gambar, sistem menjawab gambar itu tentang apa. Input berupa gambar, output berupa kelas atau label.
Dari definisi sesederhana itu, lahir banyak aplikasi yang dipakai sehari-hari: face recognition, deteksi penyakit dari gambar medis, pengenalan objek pada kendaraan otonom, sampai aplikasi belanja yang mengenali jenis sayur dari foto.
Sebelum masuk lebih dalam, ada satu hal dasar yang perlu dipahami. Bagi komputer, gambar itu sekadar angka.
Gambar terdiri dari piksel, bagian terkecil dari sebuah gambar.
Di komputer, gambar direpresentasikan sebagai matriks: baris dikali kolom, tiap sel berisi angka intensitas cahaya di titik itu.
Gambar berwarna adalah gabungan tiga matriks: Merah (R), Hijau (G), Biru (B), ditumpuk jadi satu struktur 3 dimensi.
🎯 Coba Tebak Dulu: Kalau sebuah gambar berwarna berukuran 100×100 piksel, ada berapa banyak matriks yang menyusunnya?
Jawaban: 3 matriks (R, G, B), masing-masing berukuran 100×100. Ditumpuk jadi satu blok data berukuran 100×100×3.
Computer Vision vs Image Processing
Dua istilah ini sering ketuker, padahal tujuannya beda.
| Image Processing | Computer Vision | |
|---|---|---|
| Tujuan | Memanipulasi tampilan gambar | Menginterpretasi isi gambar |
| Input | Gambar | Gambar atau video |
| Output | Gambar versi olahan | Interpretasi: deskripsi, koordinat, kelas |
| Contoh | Sharpening, blur, edge detection | Object detection, image classification |
Salah satu teknik image processing yang jadi fondasi CNN adalah convolution: proses menggeser sebuah kernel (matriks kecil) ke seluruh bagian gambar untuk menghasilkan efek tertentu.
Pertanyaan yang sering muncul: apakah angka-angka di kernel itu harus ditentukan manual satu per satu? Jawabannya tidak. Nilai kernel di-initialize secara random, lalu diperbarui otomatis lewat proses training sampai model menemukan sendiri kernel terbaik untuk datanya. Kernel yang ditentukan manual sifatnya kaku dan tidak adaptif. Lewat training, kemampuan model dalam mengekstrak fitur menyesuaikan dengan data yang dipelajari.
Inilah yang mendasari topik utama artikel ini: image classification dengan CNN (Convolutional Neural Network).
Anatomi CNN: Backbone vs Head
CNN bekerja lewat dua fase: melihat detail dulu, baru memutuskan. Dua fase ini disebut Backbone dan Head.
Backbone, si pengekstrak fitur
Backbone bertugas mempelajari fitur visual dari gambar: tepi, sudut, tekstur, pola, sampai objek. Cara kerjanya bertahap. Layer awal menangkap fitur sederhana seperti garis dan bentuk dasar. Layer yang lebih dalam menangkap fitur yang makin kompleks, dari bagian objek sampai objek utuh. Seiring makin dalam jaringannya, ukuran spasial gambar makin mengecil, sementara informasinya makin padat.
Di dalam tiap convolutional layer ada kernel (filter) yang menyapu gambar dan menghasilkan feature map. Dua parameter kuncinya:
in_channels, jumlah channel input. Untuk layer pertama yang langsung menerima gambar berwarna, nilainya 3 (R, G, B).out_channels, jumlah channel output, sama dengan jumlah filter yang dipakai. Pakai 32 filter, hasilnya 32 feature map yang ditumpuk.
Filter yang banyak berguna karena tiap filter belajar mencari hal yang berbeda. Ada yang fokus ke tekstur, ada yang ke warna, ada yang ke tepi objek. Semakin banyak filter, semakin kaya aspek visual yang bisa ditangkap model.
⚠️ Aturan wajib saat menyusun layer:
in_channels(atauin_features) suatu layer harus sama denganout_channels(atauout_features) layer sebelumnya. Kalau tidak, siap-siap ketemu error saat kode dijalankan. Ini kesalahan paling umum pemula saat pertama kali merancang arsitektur CNN sendiri.
Linear layer hanya menerima input berbentuk vektor 1 dimensi, sementara gambar berbentuk matriks. Kalau tetap mau pakai linear layer, gambar harus di-flatten dulu. Contoh: gambar 28×28 di-flatten jadi vektor berukuran 784 (28 dikali 28). Untuk gambar besar, katakanlah 1000×1000 piksel, hasil flatten-nya jadi raksasa dan tidak efisien.
Convolutional layer istimewa karena bisa langsung menerima input berbentuk matriks. Lewat proses ekstraksi bertahap, ukurannya sudah mengecil dan padat informasi sebelum akhirnya di-flatten.
Tidak perlu merancang backbone dari nol juga. Sudah ada arsitektur populer yang terbukti bagus dan tinggal dipakai: ResNet, VGG, EfficientNet.
Head, si pengambil keputusan
Setelah backbone selesai mengekstrak fitur, hasilnya (berupa vektor setelah di-flatten) diteruskan ke head untuk diklasifikasikan. Head biasanya berupa satu atau beberapa fully connected (FC) layer.
Tiap neuron di FC layer terhubung ke semua neuron di layer sebelumnya, makanya disebut fully connected. Layer output terakhir wajib punya jumlah neuron sama dengan jumlah kelas. Klasifikasi digit 0 sampai 9 berarti 10 neuron output, dataset 15 jenis sayuran berarti 15 neuron output.
Layer terakhir biasanya pakai softmax, yang mengubah nilai output jadi probabilitas tiap kelas. Kelas dengan probabilitas tertinggi jadi jawaban model.
🎯 Coba Tebak Dulu: Model dilatih untuk klasifikasi hewan dengan 3 kelas: kucing, anjing, panda. Output softmax-nya
[0.15, 0.15, 0.70]. Model memprediksi gambar itu apa?Jawaban: Panda, karena nilai probabilitasnya paling tinggi dibanding kucing dan anjing.
Alur singkatnya: backbone mengubah gambar mentah jadi representasi fitur lewat konvolusi, pooling, dan aktivasi non-linear. Head menerima fitur itu dan memutuskan kelas paling sesuai berdasarkan probabilitas softmax.
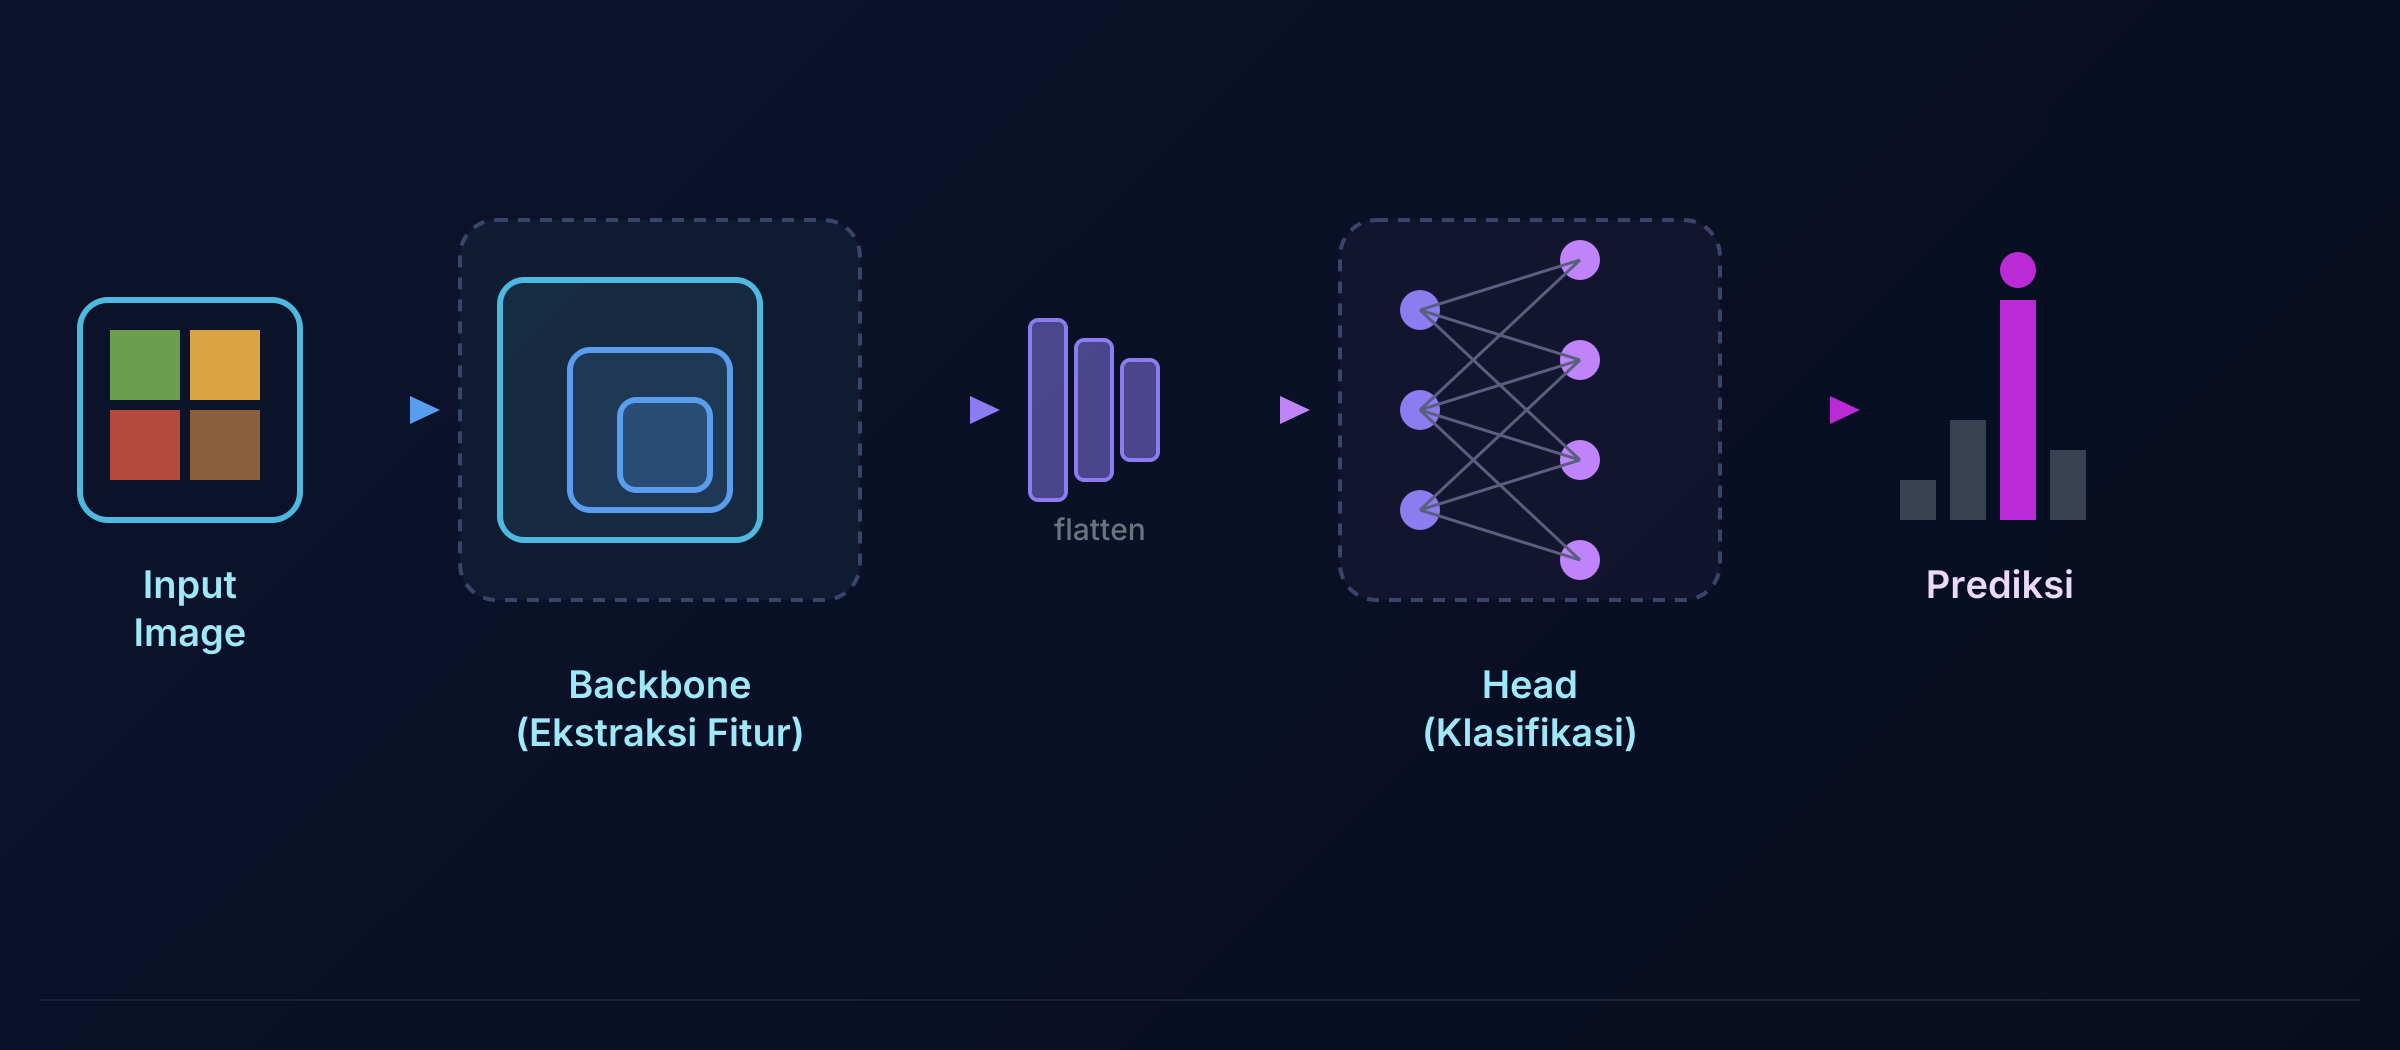
Gambar mentah diekstrak jadi feature map yang mengecil, di-flatten jadi vektor, lalu diklasifikasikan lewat FC layer sampai keluar prediksi.
Kenalan Sama PyTorch
PyTorch adalah tools untuk membangun dan melatih model deep learning. Konsepnya mirip NumPy, jadi kalau sudah familiar dengan NumPy, proses belajarnya jauh lebih cepat. Bedanya, PyTorch sudah terintegrasi dengan akselerator hardware: CUDA GPU, Apple Silicon, atau tetap CPU.
Beberapa hal dasar yang perlu diketahui:
Data type default: bilangan bulat jadi
int64, bilangan desimal jadifloat32.Device default sebuah tensor adalah CPU. Pindah ke GPU tinggal panggil
.to('cuda').Autograd adalah mekanisme PyTorch untuk menghitung gradien secara otomatis, inti dari proses training. Perhitungan gradien ini sudah otomatis dilakukan PyTorch, tidak perlu dihitung manual.
import torch

x = torch.randn(2, 2)
x = x.to('cuda')

a = torch.ones(2, 3)
b = torch.zeros(2, 3)
c = a + b
Membangun CNN dari Nol
Linear Layer
import torch.nn as nn

layer = nn.Linear(in_features=5, out_features=10)
Layer ini menerima 5 nilai input dan mengeluarkan 10 nilai output. Karena fully connected, ada 5 dikali 10 koneksi di baliknya.
Custom Model
Untuk membangun arsitektur sendiri, dibuat sebuah class yang meng-extend nn.Module. Ini wajib. PyTorch didesain agar setiap model yang dibuat dikenali sebagai model deep learning, supaya proses training bisa dijalankan terhadapnya.
import torch.nn as nn

class SimpleCNN(nn.Module):
    def __init__(self, num_classes):
        super().__init__()
        self.block1 = nn.Sequential(
            nn.Conv2d(in_channels=3, out_channels=10, kernel_size=3),
            nn.ReLU(),
        )
        self.block2 = nn.Sequential(
            nn.Conv2d(in_channels=10, out_channels=10, kernel_size=3),
            nn.ReLU(),
        )
        self.flatten = nn.Flatten()
        self.classifier = nn.Linear(in_features=10 * 24 * 24, out_features=num_classes)

    def forward(self, x):
        x = self.block1(x)
        x = self.block2(x)
        x = self.flatten(x)
        x = self.classifier(x)
        return x
Tiga hal yang perlu diperhatikan:
in_channelsblock kedua (10) harus sama denganout_channelsblock pertama (10).in_featurespadaclassifierharus cocok dengan ukuran hasil flatten. Untuk input 28×28 tanpa padding, tiap Conv2d dengan kernel 3 mengecilkan sisi gambar sebanyak 2 piksel: 28 jadi 26, lalu 26 jadi 24. Jadi ukuran akhirnya 24×24, danin_features= 10 dikali 24 dikali 24. Kalau bingung menghitung manual, cara praktisnya adalah mencetak (print) shape output di tiap block untuk mengecek ukurannya langsung.out_featuresdi layer terakhir harus sama dengan jumlah kelas dataset.
Transfer Learning
Daripada merancang arsitektur dari nol, backbone yang sudah pretrained dan terbukti bagus bisa langsung dipakai. Tersedia lewat model zoo torchvision. Beberapa nama besar: ResNet, VGG, EfficientNet.
Caranya: load backbone-nya, lalu override layer classifier terakhir sesuai jumlah kelas. Penamaan layer berbeda-beda tiap arsitektur.
import torch.nn as nn
from torchvision import models

# EfficientNet-B1
model = models.efficientnet_b1(weights="IMAGENET1K_V1")
model.classifier[1] = nn.Linear(in_features=1280, out_features=15)

# ResNet-50
model = models.resnet50(weights="IMAGENET1K_V1")
model.fc = nn.Linear(in_features=2048, out_features=15)
Arsitektur seperti ini sudah terbukti bagus mengekstrak fitur visual secara umum. Fokusnya jadi tinggal mengajari model mengenali kelas-kelas spesifik di dataset yang dipakai.
Menyiapkan Dataset
Ada dua pendekatan populer untuk menyusun data sebelum training.
Folder per Kelas
dataset/
├── train/
│   ├── class1/
│   │   ├── image1.jpg
│   │   └── image2.jpg
│   └── class2/
│       ├── image3.jpg
│       └── image4.jpg
├── val/
│   ├── class1/
│   └── class2/
Tiap gambar diletakkan di folder sesuai kelasnya. Pendekatan ini didukung langsung oleh fungsi bawaan framework: ImageFolder di PyTorch, ImageDataGenerator di TensorFlow.
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

transform = transforms.Compose([
    transforms.Resize((128, 128)),
    transforms.ToTensor()
])

train_dataset = datasets.ImageFolder(root='dataset/train', transform=transform)
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
Kelebihannya: gampang dipahami, banyak framework yang mendukung langsung. Kekurangannya: kurang fleksibel kalau nama file acak atau butuh info tambahan (misalnya multilabel).
File CSV
Alternatifnya, pakai file CSV berisi path gambar dan labelnya.
image_path,class_label
dataset/images/image1.jpg,0
dataset/images/image2.jpg,1
dataset/images/image3.jpg,0
import pandas as pd
from PIL import Image
from torch.utils.data import Dataset, DataLoader
from torchvision import transforms

class CustomDataset(Dataset):
    def __init__(self, csv_file, transform=None):
        self.data = pd.read_csv(csv_file)
        self.transform = transform

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        img_path = self.data.iloc[idx, 0]
        image = Image.open(img_path)
        label = int(self.data.iloc[idx, 1])
        if self.transform:
            image = self.transform(image)
        return image, label

transform = transforms.Compose([
    transforms.Resize((128, 128)),
    transforms.ToTensor()
])

train_dataset = CustomDataset(csv_file='dataset/train_labels.csv', transform=transform)
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
Lebih fleksibel, terutama untuk dataset dengan metadata tambahan atau file yang tersebar di direktori yang tidak terorganisir. Konsekuensinya, butuh kode custom karena tidak ada dukungan bawaan langsung dari framework.
📌 Kapan pakai yang mana? Dataset sudah rapi per kategori dan sederhana, pakai folder. Dataset kompleks dengan metadata tambahan atau file berantakan, pakai CSV.
Dataset vs DataLoader
Dataset menampung semua data, gambar dan label sekaligus. Ambil satu sampel dari dataset, hasilnya satu gambar plus satu label. Memberi seluruh dataset sekaligus ke model biasanya tidak memungkinkan karena keterbatasan memori GPU.
DataLoader memecah dataset jadi batch, kelompok kecil yang diproses bertahap. DataLoader(batch_size=128) menghasilkan batch berbentuk [128, 3, 64, 64]: 128 gambar, 3 channel RGB, ukuran 64×64, beserta 128 labelnya.
Training Loop
Setiap epoch (satu putaran penuh lewat seluruh data training) melewati tahapan berikut.
model.train()
train_loss, train_acc = 0, 0

for images, labels in train_loader:
    images, labels = images.to(device), labels.to(device)

    outputs = model(images)
    loss = criterion(outputs, labels)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    train_loss += loss.item()
    train_acc += (outputs.argmax(1) == labels).float().mean().item()

train_loss /= len(train_loader)
train_acc /= len(train_loader)
Tahap test/validation alurnya mirip, hanya saja tanpa loss.backward() dan optimizer.step(). Tahap ini murni evaluasi, bukan belajar.
Loss function untuk kasus multi-kelas: Cross Entropy Loss.
Terakhir, simpan model kalau performanya membaik, supaya bisa dipakai lagi nanti tanpa training ulang dari nol.
if test_acc > best_acc:
    best_acc = test_acc
    torch.save(model.state_dict(), 'best_model.pth')
Cheat Sheet
[ ] CNN terdiri dari Backbone (ekstraksi fitur) dan Head (klasifikasi)
[ ]
in_channels/in_featureslayer saat ini harus sama denganout_channels/out_featureslayer sebelumnya[ ]
out_channelssama dengan jumlah filter yang dipakai[ ] Output layer terakhir punya neuron sebanyak jumlah kelas
[ ] Linear layer butuh input 1D, gambar harus di-flatten dulu
[ ] Convolutional layer bisa langsung menerima input matriks
[ ] Nilai kernel tidak ditentukan manual, didapat lewat training
[ ] Dataset menampung data, DataLoader memecahnya jadi batch
[ ] Transfer learning memakai backbone pretrained, cukup override classifier-nya
[ ] Loss function untuk multi-kelas: Cross Entropy Loss
Uji Pemahaman Kamu
1. Kenapa gambar tidak bisa langsung dimasukkan ke linear layer?
Jawaban: Linear layer hanya menerima input berbentuk vektor 1 dimensi, sedangkan gambar berbentuk matriks. Solusinya di-flatten dulu, atau langsung pakai convolutional layer yang memang didesain menerima input matriks.
2. Kalau sebuah convolutional layer memakai 64 filter, berapa out_channels-nya?
Jawaban: 64 —
out_channelsselalu sama dengan jumlah filter yang digunakan.
3. Dataset kamu punya 20 kelas gambar buah. Berapa jumlah neuron di output layer terakhir?
Jawaban: 20 — jumlah neuron output harus sama dengan jumlah kelas.
4. Apa bedanya training step dan test/validation step dalam training loop?
Jawaban: Alurnya mirip: forward pass, hitung loss. Bedanya test/validation step tidak melakukan optimisasi (backpropagation dan update parameter), karena tahap ini murni untuk mengevaluasi, bukan melatih model.
5. Kapan sebaiknya pakai pendekatan CSV dibanding folder per kelas?
Jawaban: Saat dataset punya informasi tambahan (metadata, multilabel) atau gambarnya tersebar di direktori yang tidak terorganisir rapi per kelas. CSV memberi fleksibilitas lebih meski butuh sedikit kode custom.
Artikel berikutnya melanjutkan dari sini: melatih model asli untuk membedakan 102 jenis bunga, lengkap sampai jadi API yang bisa dipanggil aplikasi lain.
Bagian dari seri belajar Computer Vision.