Single Object Detection: Kenapa Bounding Box-nya Tidak Pas
Daftar Isi
📚 Series Computer Vision — Sesi 3. Part 3 dari 3, bagian terakhir. Ini bagian paling panjang, dan menurut saya paling berharga dari seluruh series ini.
Recap Singkat
Part 2 menutup dengan model v1 yang IoU test-nya 0.7186. Angka itu terlihat lumayan di atas kertas. Tapi begitu model itu dites pakai foto-foto yang sama sekali tidak ada di dataset training, mulai muncul pola yang tidak terduga.
Bagian ini menceritakan dua iterasi lanjutan (v2 dan v3), proses debugging di antaranya, dan satu temuan yang mengubah cara saya membaca angka evaluasi dari model kecil seperti ini.
Iterasi Kedua: Augmentasi dan Partial Freeze
Dugaan awal soal kenapa bounding box kadang longgar: mungkin modelnya terlalu "hafal" kondisi pencahayaan yang ada di 241 gambar training, dan gagap begitu ketemu kondisi yang berbeda.
Dua perubahan dicoba sekaligus:
1. Data augmentation, khusus di train split. ColorJitter (brightness, contrast, saturation, hue) ditambahkan supaya model belajar bahwa objek yang sama tetap objek yang sama walau pencahayaannya beda. Augmentasi ini sengaja tidak diterapkan ke test set, supaya angka evaluasi tetap representatif.
2. Partial backbone freeze. Alih-alih fine-tune seluruh MobileNetV2, 14 dari 19 blok awal dibekukan. Idenya, fitur umum dari pretraining ImageNet biasanya sudah cukup tahan terhadap variasi pencahayaan, dan fine-tuning penuh di atas dataset kecil (241 gambar) berisiko malah merusak fitur itu.
class ObjectDetectionModel(nn.Module):
    def __init__(self, freeze_until=14):
        super(ObjectDetectionModel, self).__init__()
        self.backbone = mobilenet_v2(weights="DEFAULT").features
        for i, block in enumerate(self.backbone):
            if i < freeze_until:
                for param in block.parameters():
                    param.requires_grad = False
        self.classifier = nn.Sequential(
            nn.AdaptiveAvgPool2d((1, 1)),
            nn.Flatten(),
            nn.Linear(1280, 512),
            nn.ReLU(),
            nn.Linear(512, 5)
        )
    # forward() sama seperti v1
Hasilnya:
| Metrik | v1 | v2 |
|---|---|---|
| Best IoU (test) | 0.7186 | 0.7276 |
| IoU (train, akhir) | 0.8382 | 0.8085 |
| Gap train/test | 0.120 | 0.081 |
IoU test naik tipis, tapi yang lebih menarik adalah gap-nya mengecil cukup jauh. Model v2 "kurang hafal" data trainingnya sendiri dibanding v1, tapi generalisasinya jadi lebih sehat. Di atas kertas, ini kelihatan seperti perbaikan yang jelas.
🤔 Coba Tebak Dulu: menurutmu, begitu v2 dites dengan foto dunia nyata, hasilnya bakal lebih baik dari v1 di semua kasus? Klik untuk lihat jawaban.
Kalau kamu jawab "belum tentu", tebakanmu tepat. Bagian selanjutnya menunjukkan kenapa.
Menguji Model dengan Foto Dunia Nyata
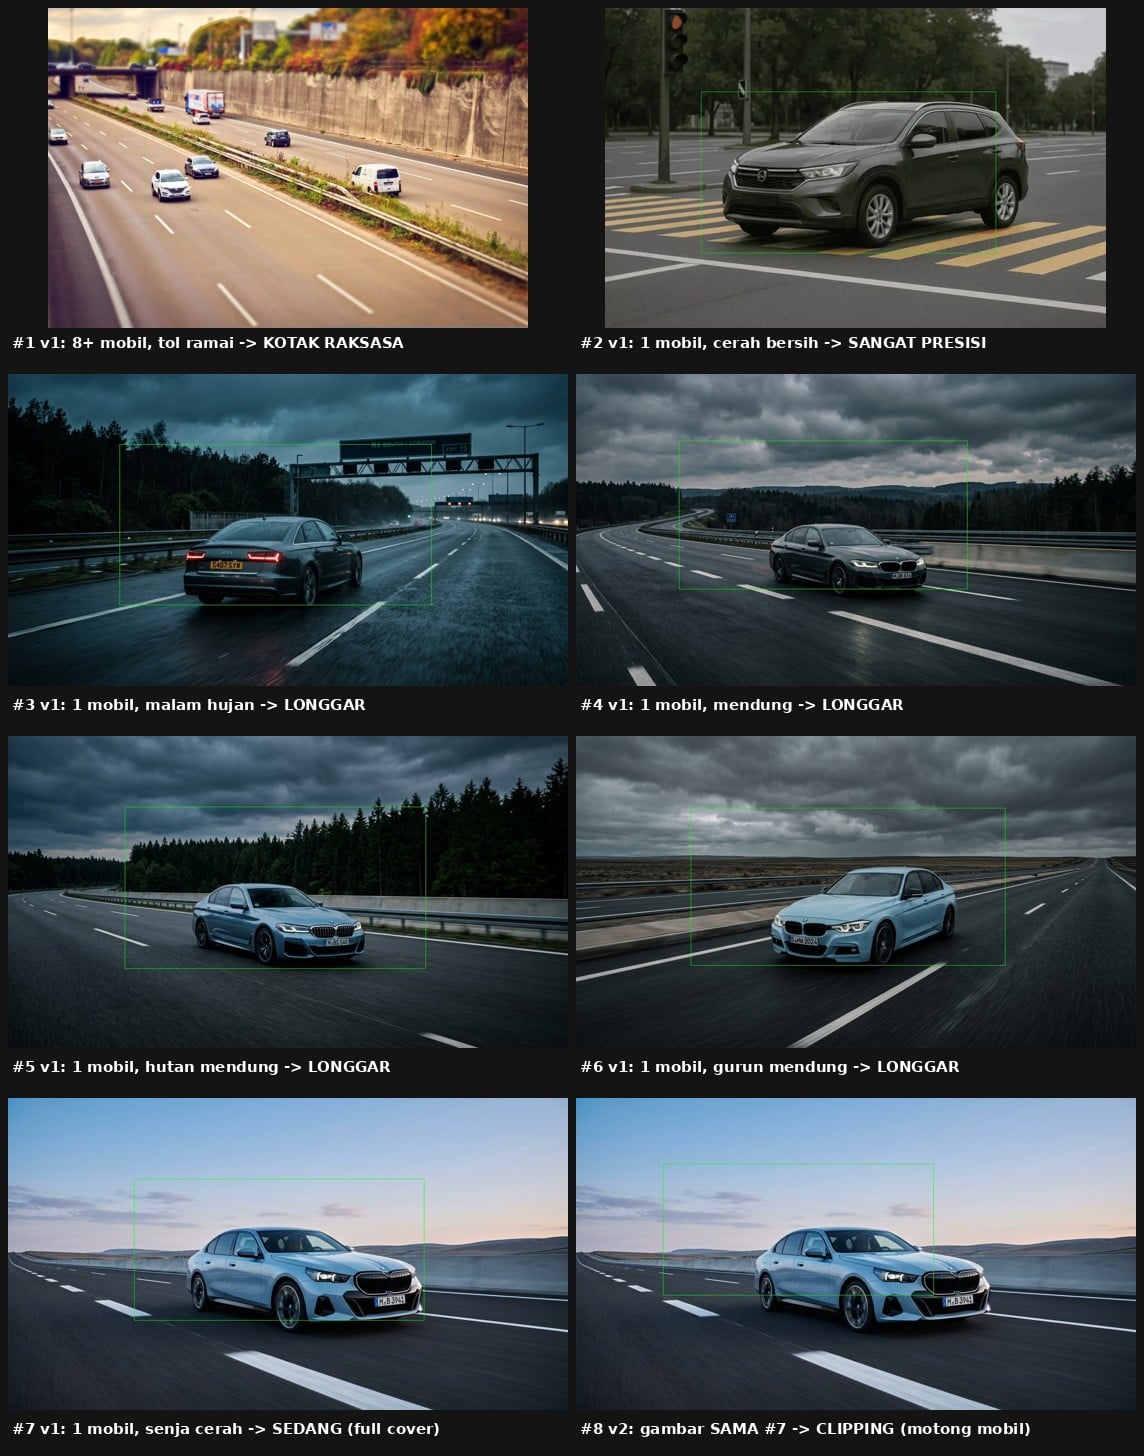
Angka IoU di atas dihitung dari test set yang berasal dari distribusi yang sama dengan data training. Untuk melihat gambaran yang lebih jujur, model v1 dites pakai foto-foto yang diambil dari luar dataset sama sekali, dengan kondisi yang jauh lebih beragam.
Beberapa hasilnya:
Foto jalan tol dengan 8 lebih mobil sekaligus: model menghasilkan satu kotak raksasa yang meliputi beberapa mobil, bukan memilih satu. Ini sebenarnya wajar. Arsitekturnya memang didesain untuk satu objek per gambar, jadi begitu dikasih adegan ramai, dia bingung.
Foto satu mobil, background bersih, siang cerah: hasilnya sangat presisi, kotaknya pas menutupi bodi mobil.
Beberapa foto satu mobil dengan langit gelap atau mendung dramatis: hasilnya konsisten longgar, kotaknya lebih besar dari mobilnya dan meluas ke background.
Empat dari empat foto berlangit gelap/dramatis menunjukkan pola yang sama: kotak longgar. Satu-satunya foto berlangit cerah-netral menghasilkan kotak paling presisi. Pola ini cukup konsisten untuk dicurigai bukan kebetulan, meski jumlah sampelnya masih kecil untuk disebut kesimpulan yang pasti.
Plot Twist: Kotak yang Motong Objek
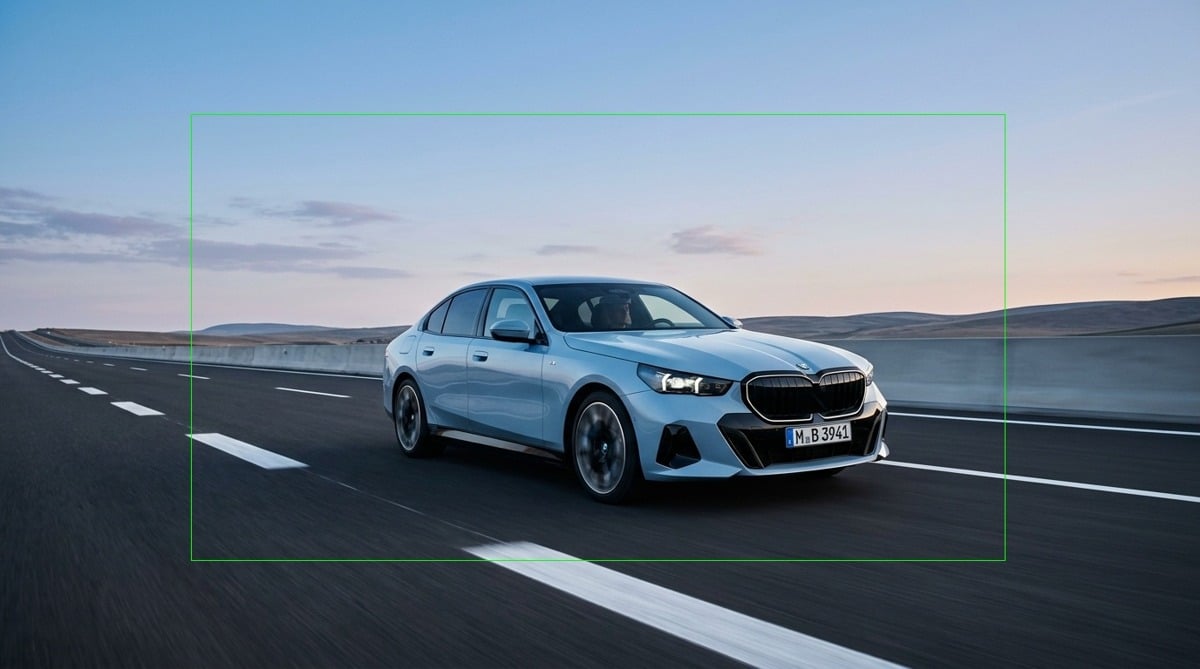
Untuk membandingkan v1 dan v2 secara langsung, satu foto yang sama dites di kedua model. Foto ini kebetulan punya langit senja yang cukup cerah.
Hasil v1: kotak menutupi seluruh mobil, sedikit longgar di bagian atas.
Hasil v2, di foto yang sama persis: kotaknya justru memotong bagian depan mobil. Bumper dan sebagian grille berada di luar kotak.
Ini kebalikan dari yang diharapkan. v2 menang di angka agregat (IoU test naik, gap mengecil), tapi kalah di kasus spesifik ini. Bukan soal v2 "lebih buruk" secara mutlak, tapi v2 menukar satu jenis kesalahan dengan jenis lain. Kotak yang longgar itu masih "aman" karena objeknya tetap ke-cover seluruhnya. Kotak yang memotong objek jelas lebih bermasalah untuk kebutuhan praktis.
🧠 Kenapa ini bisa terjadi meski metrik agregatnya membaik? Klik untuk lihat penjelasan.
Metrik IoU di test set adalah rata-rata dari puluhan gambar. Rata-rata yang membaik tidak menjamin performa yang lebih baik di setiap gambar individual, apalagi kalau gambar itu (foto dunia nyata, bukan bagian dari dataset asli) berada jauh di luar distribusi data training. Ini pengingat penting: metrik agregat dan perilaku kualitatif per-kasus adalah dua hal yang berbeda, dan keduanya perlu dicek.
Iterasi Ketiga: Split Head dan IoU Loss
Dua perubahan lagi dicoba, kali ini menyasar sesuatu yang lebih fundamental: arsitektur head-nya sendiri.
Masalahnya: AdaptiveAvgPool2d((1, 1)) meratakan seluruh feature map jadi satu vektor sebelum memprediksi bounding box. Untuk klasifikasi (ada objek atau tidak), ini tidak masalah. Tapi untuk regresi lokasi presisi, ini seperti meminta seseorang menebak posisi mobil di foto setelah fotonya diblur habis-habisan. Informasi "di mana"-nya sudah keburu hilang sebelum sampai ke bagian yang memprediksi koordinat.
Perubahan 1: Split head. Cabang is_object tetap pakai pooling ke 1x1 (cukup untuk klasifikasi). Cabang bbox diberi jalur sendiri yang mempertahankan grid spasial 4x4 sebelum masuk fully connected layer.
self.objectness_head = nn.Sequential(
    nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(),
    nn.Linear(1280, 256), nn.ReLU(), nn.Linear(256, 1),
)
self.bbox_head = nn.Sequential(
    nn.Conv2d(1280, 256, kernel_size=1), nn.ReLU(),
    nn.AdaptiveAvgPool2d((4, 4)), nn.Flatten(),
    nn.Linear(256 * 4 * 4, 512), nn.ReLU(), nn.Dropout(0.3), nn.Linear(512, 4),
)
Perubahan 2: IoU loss. Ditambahkan di samping MSE (bukan menggantikan), dihitung differentiable pakai operasi tensor murni supaya bisa di-backward, dan hanya dihitung untuk sample yang benar-benar ada objeknya.
@staticmethod
def _iou_loss(pred_bbox, true_bbox, eps=1e-7):
    def to_corners(box):
        x, y, w, h = box[:, 0], box[:, 1], box[:, 2], box[:, 3]
        return x - w/2, y - h/2, x + w/2, y + h/2
    px1, py1, px2, py2 = to_corners(pred_bbox)
    tx1, ty1, tx2, ty2 = to_corners(true_bbox)
    inter_w = (torch.min(px2, tx2) - torch.max(px1, tx1)).clamp(min=0)
    inter_h = (torch.min(py2, ty2) - torch.max(py1, ty1)).clamp(min=0)
    inter_area = inter_w * inter_h
    pred_area = (px2-px1).clamp(min=0) * (py2-py1).clamp(min=0)
    true_area = (tx2-tx1).clamp(min=0) * (ty2-ty1).clamp(min=0)
    union = pred_area + true_area - inter_area + eps
    return (1 - inter_area/union).mean()
Hasilnya kali ini jauh lebih signifikan:
| Metrik | v1 | v2 | v3 |
|---|---|---|---|
| Best IoU (test) | 0.7186 | 0.7276 | 0.8100 |
| IoU (train, akhir) | 0.8382 | 0.8085 | 0.8339 |
| Gap train/test | 0.120 | 0.081 | 0.024 |
v3 unggul di kedua ukuran sekaligus: IoU test tertinggi, dan gap overfitting paling kecil dari ketiganya. Di atas kertas, ini kandidat paling kuat.
Plot Twist Kedua: Kotak yang Nyaris Identik
Foto yang sama yang bikin v2 memotong mobil, dites lagi pakai v3. Hasilnya: mobilnya ter-cover penuh lagi, masalah "motong" hilang. Tapi kotaknya jadi kotak paling longgar dari ketiga versi, hampir dua kali lebih besar dari kotak v1 di foto yang sama.
Jadi urutannya: v1 longgar sedang, v2 ketat tapi motong, v3 aman tapi paling longgar. Tiga iterasi, tiga jenis kesalahan berbeda, bukan satu solusi yang jelas-jelas terbaik di semua aspek.
Lalu muncul temuan yang lebih mengubah cara pandang. Dua foto berbeda dites dengan v3, keduanya berlangit cerah tapi mobil yang berbeda, posisi berbeda di frame:
Foto A (mobil pertama): x=686.3, y=387.2, w=932.7, h=512.0
Foto B (mobil berbeda): x=685.2, y=388.0, w=938.5, h=503.3
Selisihnya kurang dari 1% di semua koordinat. Untuk dua mobil yang berbeda, di posisi yang berbeda, di frame yang berbeda.
Sebagai pembanding, foto ketiga yang gelap dan mendung, dengan mobil dan background yang sama sekali berbeda, juga dites pakai v3:
Foto C (gelap/mendung, scene berbeda): x=678.5, y=385.6, w=878.5, h=485.9
Diletakkan bersebelahan dengan Foto A dan B, hasilnya juga berada di kisaran yang sama, tidak identik persis, tapi jauh dari perubahan drastis yang mestinya muncul kalau pencahayaan benar-benar mengubah output secara signifikan. Ini justru versi yang lebih kuat dari pola "kotak nyaris konstan" dibanding dugaan awal: tiga mobil berbeda, dua kondisi pencahayaan yang jauh berbeda, dan outputnya nyaris tidak bergerak.
(Catatan terpisah: kalau v3 dibandingkan dengan v1 di foto gelap yang sama, kotak v1 memang jauh lebih kecil. Jadi v1 dan v3 memang berperilaku berbeda satu sama lain. Yang konsisten di sini secara spesifik adalah output v3 lintas foto yang berbeda-beda.)
Apa yang Sebenarnya Dipelajari Model Ini
Dugaan yang paling masuk akal: model ini mungkin tidak benar-benar melacak tepi setiap objek secara individual. Lebih memungkinkan dia mengeluarkan sesuatu yang mendekati bentuk dan posisi kotak default, yang sebagian besar tidak bergantung pada apa yang sebenarnya ada di frame. Tiga mobil berbeda, dua kondisi pencahayaan yang jauh berbeda, dan ukuran-posisinya nyaris tidak bergeser.
Ini bukan kesimpulan yang sudah pasti benar. Cuma tiga foto luar-distribusi yang dibandingkan sedekat ini, bukan studi sistematis dengan ground truth yang dianotasi manual. Tapi dugaan ini konsisten dengan hampir semua yang diamati di tiga iterasi: kegagalan total di adegan multi-mobil (tidak ada mekanisme untuk memilih satu objek dari beberapa), kotak longgar yang kebetulan tetap menutupi objek sebagian besar waktu, dan kenapa memperbaiki satu jenis kesalahan lewat perubahan arsitektur langsung memunculkan jenis kesalahan lain alih-alih konvergen ke satu solusi yang bersih. Model yang mengeluarkan sesuatu yang mendekati tebakan tetap akan berperilaku persis seperti itu.
Kalau dugaan ini benar, itu artinya IoU test 0.81 yang terlihat bagus di atas kertas sebenarnya mengukur seberapa cocok tebakan default itu dengan ukuran dan posisi objek yang umum di distribusi data training, bukan seberapa presisi model melacak tepi objek yang sesungguhnya di sebuah foto. Dua hal itu bisa menghasilkan angka yang sama tapi maknanya jauh berbeda.
Cheat Sheet dan Pelajaran
[x] v1 (baseline): full fine-tune, head gabungan, MSE saja. IoU test 0.7186
[x] v2: + augmentasi warna + partial freeze. IoU test 0.7276, gap mengecil, tapi muncul kegagalan baru (clipping) di uji kualitatif
[x] v3: + split head + IoU loss. IoU test 0.8100, gap paling kecil, tapi paling longgar di uji kualitatif tertentu
[x] Metrik agregat yang membaik tidak menjamin perilaku yang lebih baik di setiap kasus individual
[x] Dugaan akhir: model mungkin mengeluarkan tebakan yang hampir konstan, bukan localization presisi per-objek
[x] Semua kode dan gambar hasil ada di GitHub repo, termasuk v2 dan v3 sebagai referensi
Penutup
241 gambar adalah dataset yang kecil, dan tiga iterasi ini menunjukkan batasan nyata dari itu. Bukan berarti hasilnya gagal, tapi ada baiknya membaca angka evaluasi dengan skeptis yang sehat, terutama kalau modelnya belum pernah dites di luar distribusi data yang dipakai untuk melatihnya.
Kalau ada yang mau coba melanjutkan eksperimen ini, entah menambah data, mencoba arsitektur berbasis grid/anchor yang lebih standar, atau menguji dugaan "mode-based localization" secara lebih sistematis, semua kode dan hasilnya sudah terbuka di GitHub.
📁 Dataset: Google Drive 💻 Repo: GitHub
Bagian penutup dari series Computer Vision Super Class, Sesi 3: Single Object Detection. Terima kasih sudah mengikuti sampai akhir.