Bikin Spam Classifier dengan Fine-tuning BERT
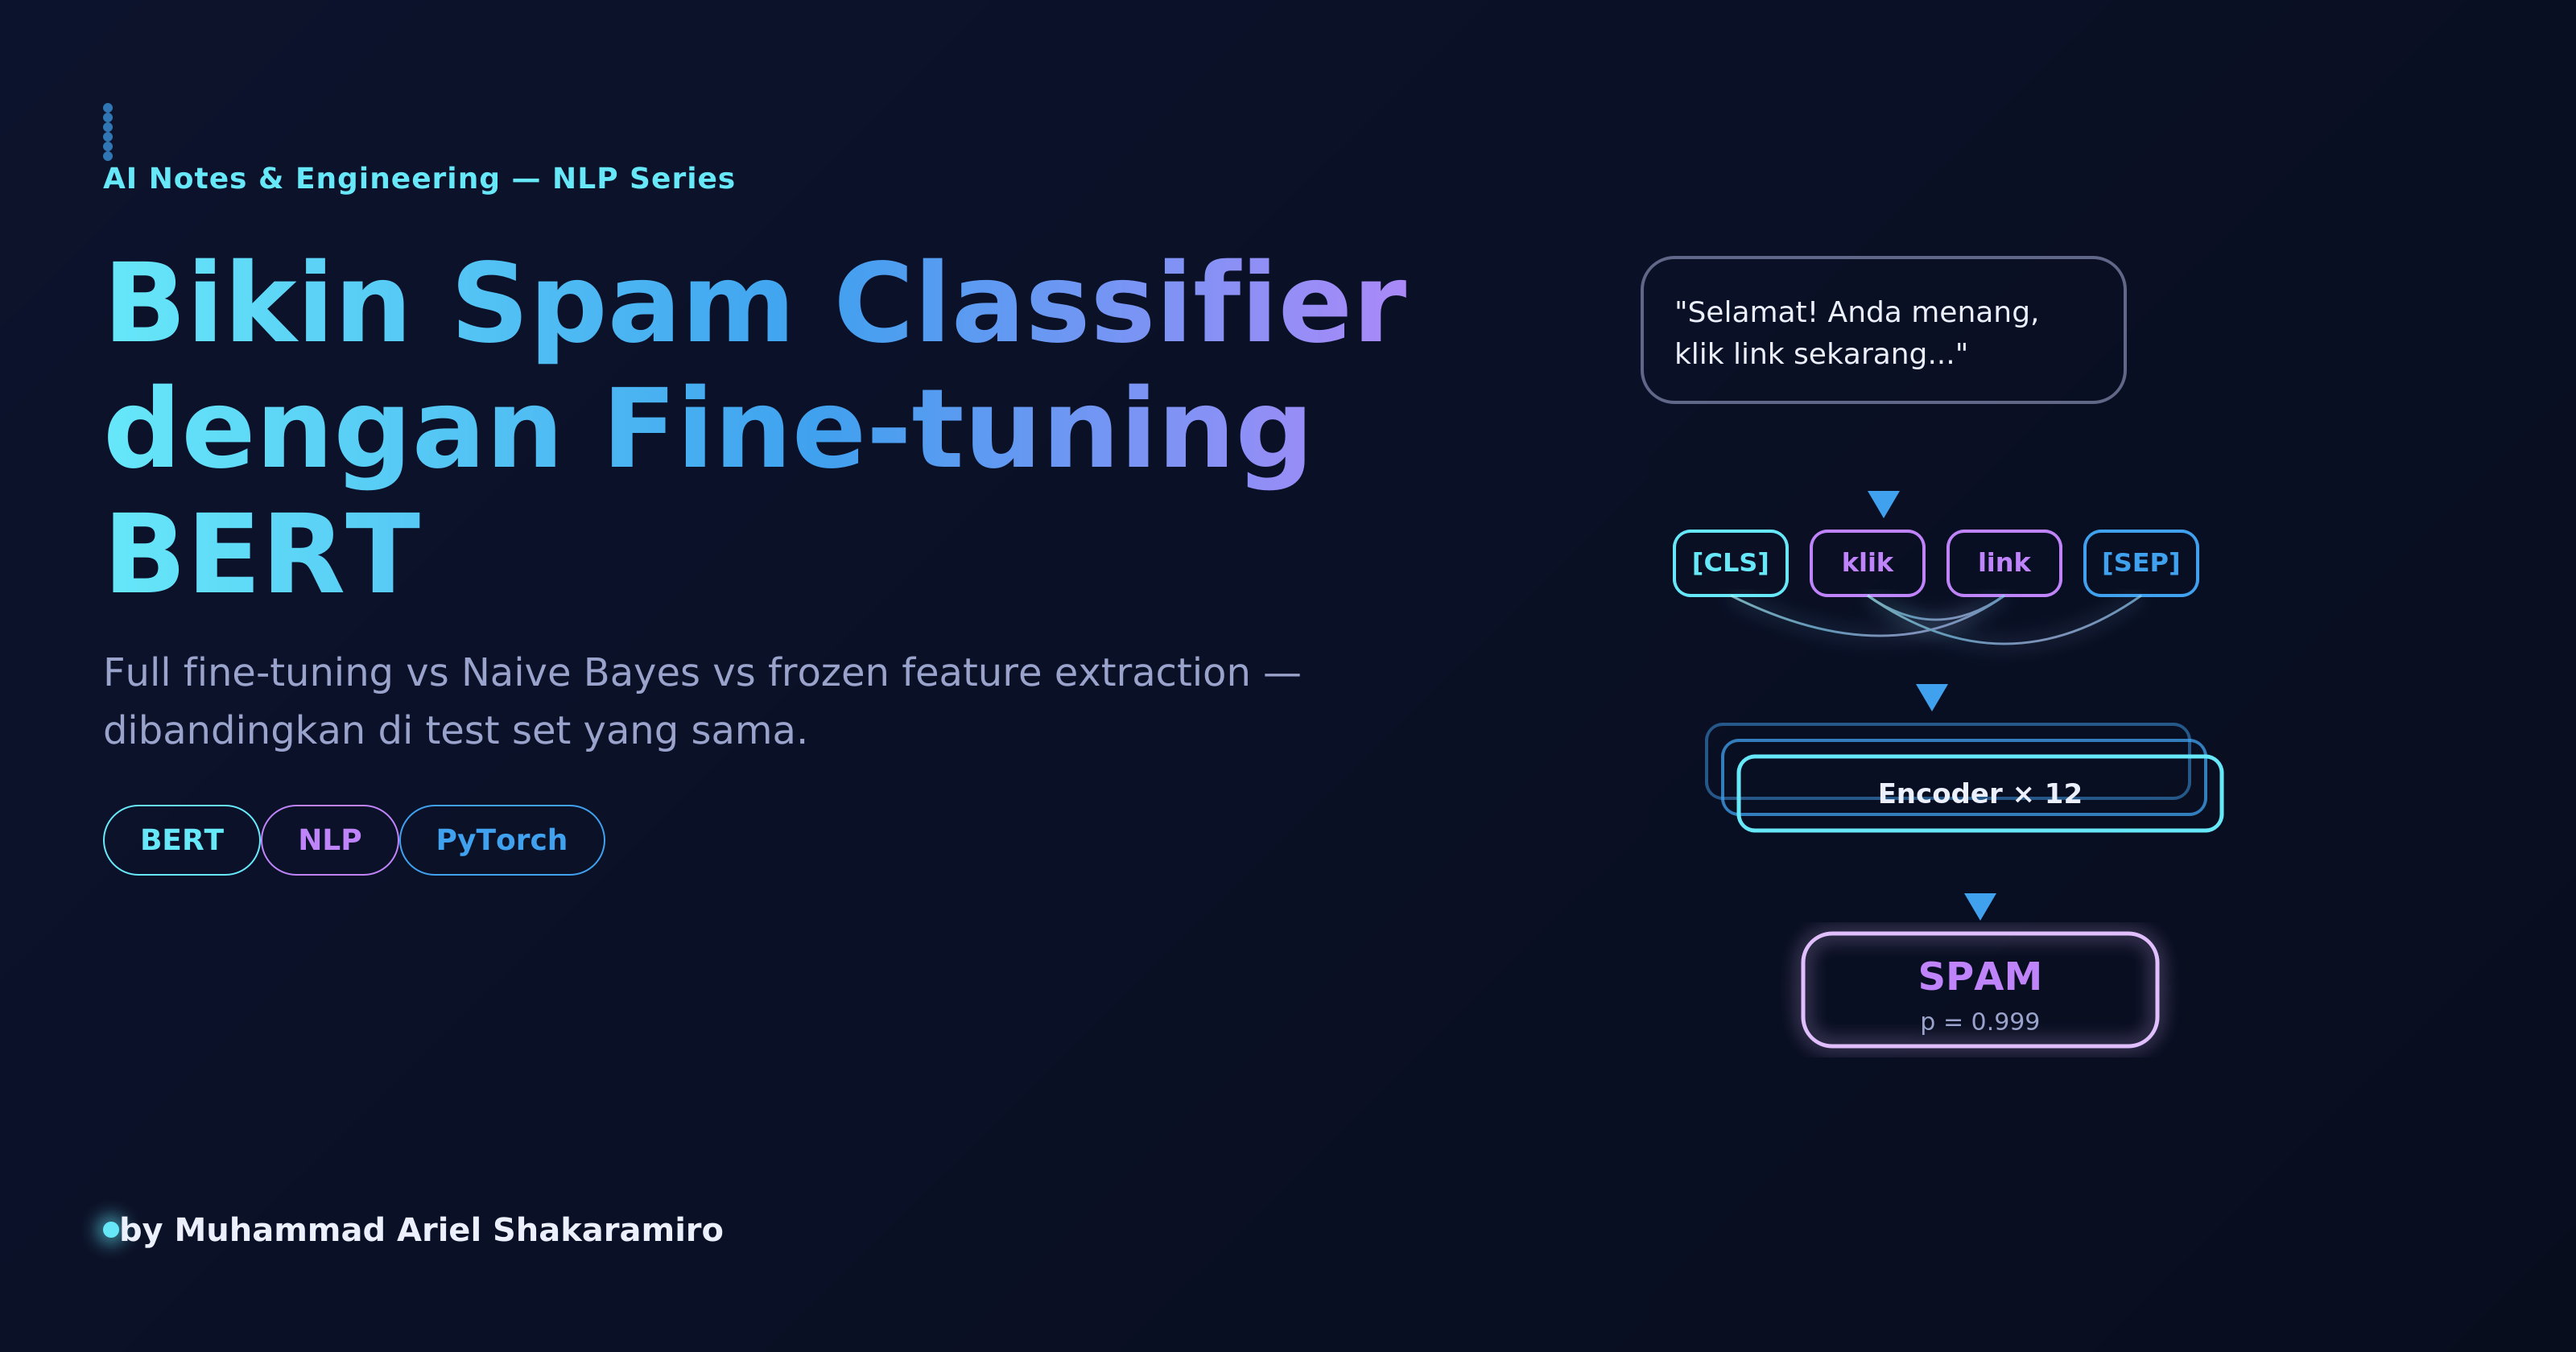
Pesan seperti "Selamat! Anda menang 10 juta, klik link untuk klaim" langsung terbaca sebagai spam oleh siapa pun yang menerimanya. Yang menarik untuk digali: komputer cuma melihat deretan huruf, jadi apa yang membuatnya bisa "tahu" hal yang sama seperti kita?
Catatan ini membahas cara membangun spam classifier dengan fine-tuning BERT: alasan BERT cocok untuk tugas ini, sampai kode yang benar-benar dijalankan dan dievaluasi.
Daftar Isi
Masalah: Spam Itu Seperti Apa?
Kita butuh aturan yang tahan variasi bahasa dan trik spam. Contoh SPAM biasanya punya ajakan cepat, iming-iming hadiah/uang, ada link atau nomor, dan nadanya mendesak:
"Pinjaman cair 5 menit, WA sekarang."
Sedangkan HAM (bukan spam) konteksnya jelas, dan tidak memaksa klik/link/transfer:
"Tolong kirim file revisi ya."
💭 Coba Tebak Dulu: Menurutmu, kenapa cara sederhana seperti "cek apakah ada kata 'gratis' atau 'klik'" gampang salah tebak?
Jawaban: karena kata yang sama bisa muncul di konteks normal — "gratis ongkir" itu wajar, tapi "gratis iPhone klik link" beda cerita. Model butuh memahami konteks, bukan cuma mendeteksi kata kunci.
Kenapa BERT, Bukan Bag-of-Words?
Ini yang bikin BERT beda dari pendekatan klasik seperti Bag-of-Words atau TF-IDF:
| Pendekatan | Fokus |
|---|---|
| Bag-of-Words / TF-IDF | Berapa kali sebuah kata muncul |
| BERT | Makna kata dalam konteks kalimat |
BERT (encoder-only Transformer) membaca kata dengan konteks kiri-kanan sekaligus lewat mekanisme self-attention. Kata "klik" akan lebih "memperhatikan" kata "link", "hadiah", "sekarang", sehingga pola spam lebih mudah terdeteksi.
Arsitektur BERT dalam 3 Blok
Tokenizer (WordPiece) — teks dipecah jadi subword. Contoh:
"playing"→"play"+"##ing".Embedding Layer — tiga embedding dijumlahkan:
Embedding final = Token Embedding + Position Embedding + Segment Embedding
- Encoder Stack + Task Head — 12 layer encoder (BERT-Base). Untuk klasifikasi, vektor
[CLS]diambil lalu dilewatkan ke Dense layer untuk menghasilkan label.
Di dalam tiap layer encoder ada Multi-Head Self-Attention (tiap token "melihat" token lain), Feed-Forward Network (memproses fitur tiap token), dan Residual + LayerNorm (menstabilkan training).
Kenapa BERT Sudah "Pintar" Sebelum Dilatih?
Sebelum fine-tuning, BERT sudah dilatih lebih dulu (pretraining) di data teks yang sangat besar, lewat dua tugas (versi klasik — beberapa model turunan seperti RoBERTa membuang tugas kedua):
Masked Language Modeling (MLM): sebagian token disembunyikan (
[MASK]), model menebak token yang hilang → belajar konteks kiri & kanan sekaligus.Next Sentence Prediction (NSP): model menebak apakah kalimat B lanjutan kalimat A → belajar hubungan antar kalimat.
Ini kenapa fine-tuning untuk tugas spesifik seperti spam classifier bisa jalan dengan data yang relatif sedikit. BERT sudah punya modal "paham bahasa" duluan.
Fine-tuning untuk Klasifikasi Spam
Arsitektur saat fine-tuning sederhana:
Teks (pesan) → BERT (encoder) → Spam? (0/1)
Yang dilatih: kepala klasifikasi (Dense) pasti dilatih, dan biasanya seluruh parameter BERT ikut di-update (end-to-end), dengan loss cross-entropy untuk 2 kelas.
Hyperparameter awal yang dipakai:
learning_rate = 2e-5
batch_size = 16
epochs = 3
max_length = 128
Dataset & Pipeline Praktik
Untuk implementasi, dipakai SMS Spam Collection v.1 (Almeida et al., 2011), dataset benchmark publik. Rilis resmi berisi 5.574 pesan SMS berbahasa Inggris; mirror GitHub yang dipakai di sini berisi 5.572 baris (selisih 2 baris dari rilis resmi, kemungkinan perbedaan parsing pada mirror).
Statistik terverifikasi (dihitung langsung dari data, bukan asumsi):
| Jumlah | |
|---|---|
| Total baris (mirror yang dipakai) | 5.572 |
| Setelah hapus duplikat | 5.169 |
| Ham | 4.516 (87,4%) |
| Spam | 653 (12,6%) |
Split stratified 80/10/10:
| Split | Total | Ham | Spam |
|---|---|---|---|
| Train | 4.135 | 3.612 | 523 |
| Validation | 517 | 452 | 65 |
| Test | 517 | 452 | 65 |
Kelas tidak seimbang (~87:13). Ini alasan kenapa metrik selain accuracy penting dibaca di bagian berikutnya.
Kode tokenisasi dan setup training (persis seperti di notebook):
MODEL_NAME = "bert-base-uncased"
MAX_LENGTH = 128

tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

def tokenize(texts):
    return tokenizer(
        list(texts),
        padding="max_length",
        truncation=True,
        max_length=MAX_LENGTH,
        return_tensors="pt",
    )

model = AutoModelForSequenceClassification.from_pretrained(MODEL_NAME, num_labels=2)
Evaluasi: Kenapa Bukan Cuma Accuracy
Dengan kelas tidak seimbang (87% ham, 13% spam), model yang asal tebak "semua ham" saja sudah dapat accuracy 87%, padahal gagal total mendeteksi spam. Karena itu kita baca:
Precision (spam): dari yang diprediksi spam, berapa yang benar-benar spam?
Recall (spam): dari spam asli, berapa yang berhasil ditangkap?
F1: rata-rata harmonik precision & recall.
Recall rendah → banyak spam lolos. Precision rendah → pesan normal ikut ketandai spam (false alarm).
| Metrik | Nilai |
|---|---|
| Accuracy | 0,9923 |
| Precision (spam) | 0,9692 |
| Recall (spam) | 0,9692 |
| F1 (spam) | 0,9692 |
Dari 517 pesan di test set: 450 ham diprediksi benar, 2 ham salah ditandai spam, 2 spam salah ditandai ham, 63 spam diprediksi benar.
Plot Twist: Apa Kata Notebook Resmi Bootcamp?
Sambil menelusuri materi bootcamp lebih jauh, ada notebook referensi resmi yang ternyata implementasinya beda dari teori di atas. Alih-alih fine-tuning penuh, notebook itu membekukan seluruh parameter BERT:
for param in bert.parameters():
    param.requires_grad = False
Yang dilatih cuma head klasifikasi custom (Linear 768→512→2) di atas BERT yang beku. Ini namanya feature extraction, bukan fine-tuning penuh seperti yang dijelaskan di bagian sebelumnya. Notebook itu juga bikin baseline Naive Bayes untuk perbandingan, dan hasilnya cukup mengejutkan: pada test set mereka, Naive Bayes (F1 spam 0,97) sedikit mengungguli BERT-frozen (F1 spam 0,94).
BERT tidak otomatis gagal di sini. Dataset SMS Spam Collection relatif kecil dan polanya cukup jelas: kata kunci seperti "free", "win", "claim" sudah sangat informatif secara statistik, sehingga model sederhana bisa ikut bersaing (interpretasi ini belum diuji langsung lewat feature importance, jadi dianggap sebagai dugaan yang masuk akal, bukan kesimpulan final). Pelajaran yang lebih pasti: performa BERT bergantung pada ukuran data, kompleksitas pola, dan apakah parameter BERT-nya benar-benar ikut di-fine-tune atau cuma dipakai sebagai ekstraktor fitur beku.
Supaya perbandingan adil (test set yang sama, bukan sekadar comot angka dari sumber lain), ketiga pendekatan — Naive Bayes, BERT-frozen, dan BERT full fine-tuning — dijalankan ulang di notebook ini pada split data yang identik:
| Model | Accuracy | Precision (spam) | Recall (spam) | F1 (spam) |
|---|---|---|---|---|
| Naive Bayes (baseline) | 0,9845 | 0,9524 | 0,9231 | 0,9375 |
| BERT frozen + head custom | 0,9845 | 0,8904 | 1,0000 | 0,9420 |
| BERT full fine-tuning | 0,9923 | 0,9692 | 0,9692 | 0,9692 |
Hasilnya: fine-tuning penuh memang unggul di semua metrik pada split ini. Tapi frozen-BERT punya recall sempurna (1,0000, artinya tidak ada satu pun spam yang lolos), meski dengan precision paling rendah di antara ketiganya (lebih banyak pesan ham yang salah ditandai spam). Ada trade-off yang berbeda di sini, tergantung mana yang lebih penting: menangkap semua spam, atau menghindari false alarm ke pesan normal.
Demo Inferensi
Setelah model dilatih, begini cara mengujinya ke teks baru:
def predict_spam(texts, model=model, tokenizer=tokenizer):
    model.eval()
    enc = tokenizer(texts, padding=True, truncation=True, max_length=MAX_LENGTH, return_tensors="pt")
    with torch.no_grad():
        logits = model(**enc).logits
        probs = torch.softmax(logits, dim=1)[:, 1]
    return [
        {"text": t, "label": "SPAM" if p >= 0.5 else "HAM", "p_spam": round(p.item(), 4)}
        for t, p in zip(texts, probs)
    ]
Contoh input yang diuji, dengan hasil aktual:
| Teks | Prediksi | p_spam |
|---|---|---|
| "Congratulations! You've won a free iPhone, click the link to claim now." | SPAM | 0,9988 |
| "Hey, what time is the meeting tomorrow?" | HAM | 0,0008 |
| "URGENT loan approved in 5 minutes, WhatsApp us now!" | HAM (meleset) | 0,0006 |
| "Can you send me the revised file, please?" | HAM | 0,0058 |
Baris ketiga menarik untuk dibahas. Teks itu sengaja ditulis mirip spam pinjaman (urgensi, ajakan kontak cepat), tapi modelnya memprediksi HAM dengan keyakinan tinggi. Dugaan penyebabnya: dataset SMS Spam Collection berasal dari sekitar 2011, sebelum "WhatsApp" jadi istilah umum di teks spam berbahasa Inggris, jadi frasa ini kemungkinan besar berada di luar pola yang pernah dilihat model saat training. Model dengan accuracy 99% pun tetap bisa salah pada kalimat yang polanya tidak ada di data latihnya.
Quiz Singkat
Q1. Kenapa BERT lebih unggul dari TF-IDF untuk mendeteksi spam yang kalimatnya bervariasi? A: Karena BERT memahami konteks kata (lewat self-attention), bukan cuma menghitung frekuensi kemunculan kata.
Q2. Kenapa accuracy saja tidak cukup untuk dataset spam yang tidak seimbang (87% ham, 13% spam)? A: Karena model yang selalu menebak "ham" pun sudah dapat accuracy tinggi tanpa benar-benar mendeteksi spam. Precision & recall dibutuhkan untuk melihat performa di kelas minoritas.
Q3. Apa beda "BERT sebagai feature extractor (frozen)" dengan "fine-tuning penuh"? A: Pada frozen, seluruh parameter BERT dibekukan (
requires_grad=False) dan hanya head klasifikasi custom yang dilatih. Pada fine-tuning penuh, seluruh parameter BERT ikut ter-update bersama head-nya. Frozen lebih cepat & hemat komputasi, tapi tidak selalu lebih akurat.
Q4. Model di atas dapat accuracy 99,23% di test set, tapi salah memprediksi "URGENT loan approved in 5 minutes, WhatsApp us now!" sebagai HAM. Kenapa ini bisa terjadi? A: Accuracy tinggi di test set hanya mengukur performa pada data yang polanya mirip dengan data training. Kalimat itu memakai istilah ("WhatsApp") yang kemungkinan tidak ada di dataset training (sekitar 2011), jadi berada di luar distribusi yang pernah dipelajari model. Accuracy tinggi tidak menjamin generalisasi ke pola baru.
Checklist Ringkasan
[x] Paham alur: data → tokenisasi → fine-tuning → evaluasi
[x] Paham input BERT: token, posisi, segment embedding
[x] Tahu cara melatih BERT untuk klasifikasi 2 kelas
[x] Bisa membaca precision, recall, F1, confusion matrix
[x] Bisa menguji prediksi pada teks baru
[x] Paham beda BERT sebagai feature extractor (frozen) vs fine-tuning penuh
[x] Paham kenapa accuracy tinggi di test set tidak menjamin model benar di semua pola baru
Kode lengkap tersedia di GitHub