Text Recognition: Gimana Mesin Bisa "Membaca" Deretan Angka dari Gambar?
Daftar Isi
Kenapa Ini Penting
Coba perhatikan sekitar kamu: aplikasi scan dokumen di HP, sistem yang otomatis baca plat nomor di gerbang tol, sampai aplikasi yang bisa "mindai" struk belanja jadi catatan pengeluaran. Semuanya mengandalkan teknologi yang sama: Text Recognition, atau yang lebih sering kita dengar sebagai OCR (Optical Character Recognition).
Tulisan ini bagian dari eksplorasi saya di materi Computer Vision soal Text Recognition. Saya coba runut dari konsepnya di materi, sampai ke kode yang benar-benar saya jalankan dan verifikasi hasilnya sendiri di Colab.
Coba Tebak Dulu
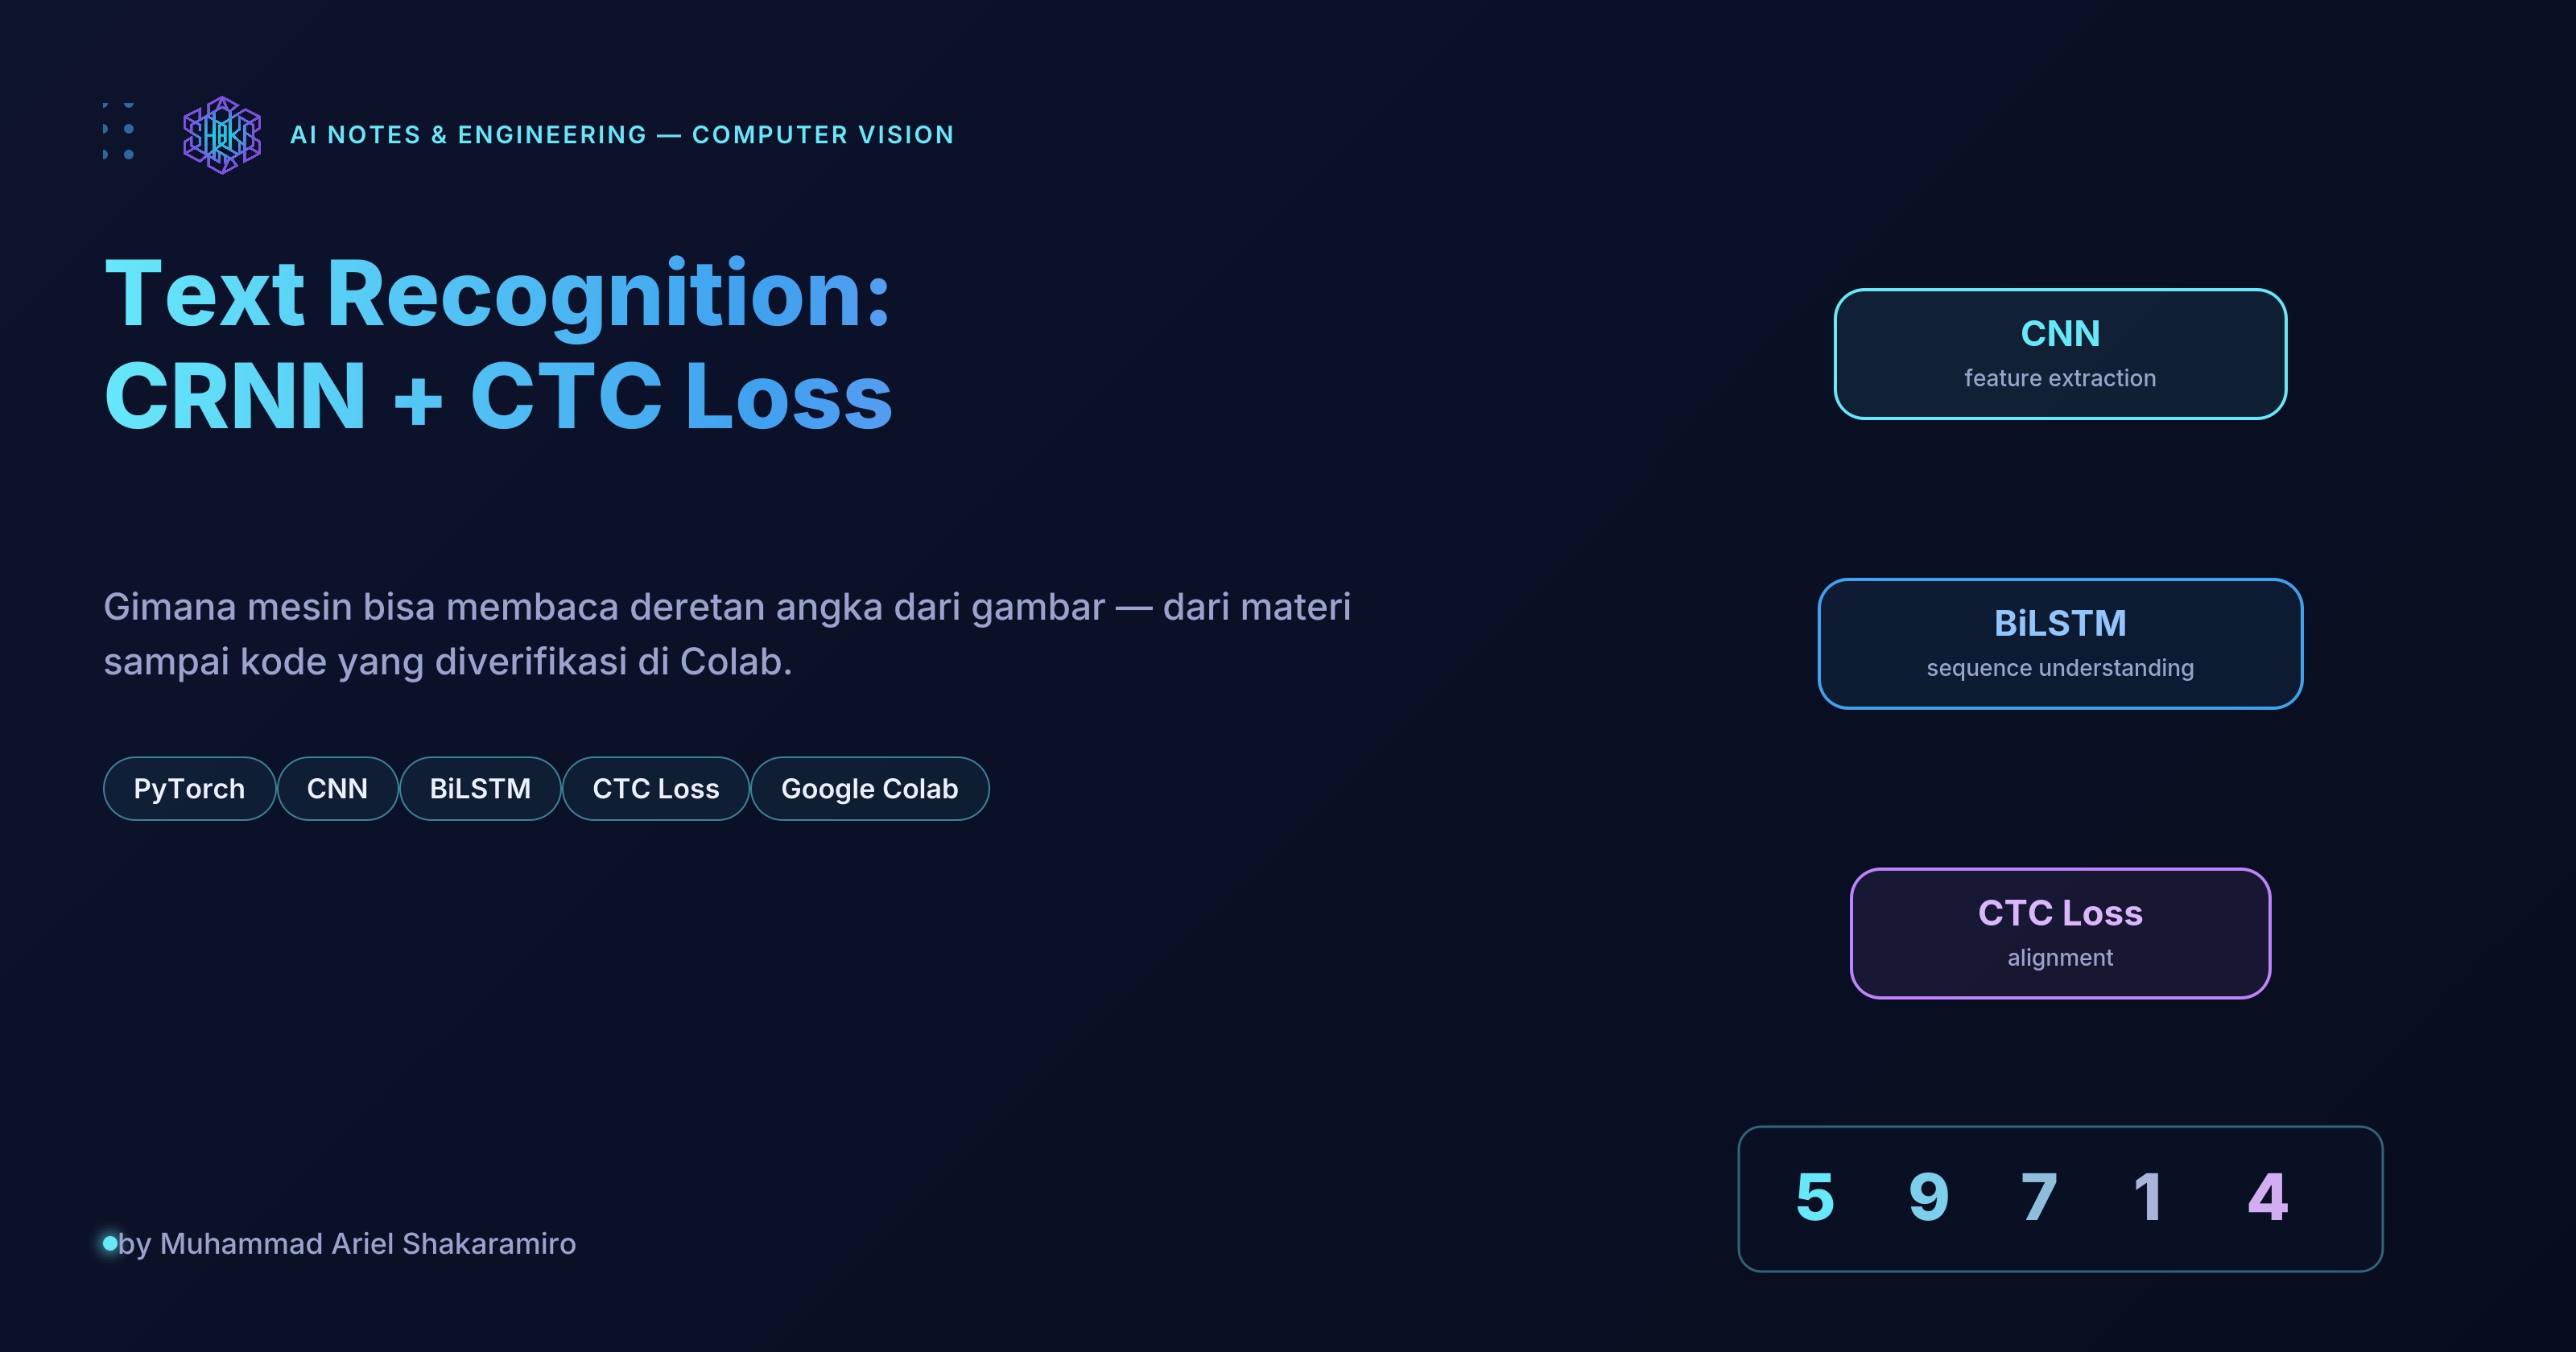
Bayangkan gambar berisi lima digit angka berdempetan tanpa spasi jelas antar karakter, misalnya seperti tulisan tangan "59714" yang digambar rapat-rapat.
Pertanyaannya: gimana caranya sebuah model tahu itu 5 karakter terpisah (5, 9, 7, 1, 4), bukan satu bentuk aneh tunggal? Dan gimana modelnya "belajar" hal ini kalau di data training pun nggak ada info persis di piksel mana batas antar karakternya?
Jawabannya ada di kombinasi tiga hal yang akan kita bahas satu-satu: CNN, LSTM, dan satu fungsi loss yang namanya agak menakutkan tapi konsepnya elegan — CTC.
Apa Itu Text Recognition (OCR)
Text recognition adalah teknologi yang dipakai untuk mengenali dan mengekstrak teks dari gambar, dokumen, atau objek fisik seperti papan tanda atau layar. Intinya, mesin "membaca" teks dalam format non-digital (tulisan tangan atau cetakan) lalu mengubahnya jadi data yang bisa diolah secara digital.
Beberapa penerapan yang paling umum:
Pemindaian dokumen
Pengenalan plat nomor kendaraan
Sistem pemrosesan faktur otomatis
Kenapa CNN Saja Nggak Cukup
Kalau kamu sudah familiar dengan image classification, CNN (Convolutional Neural Network) mungkin kedengaran cukup buat "membaca" gambar. Tapi ada bedanya.
CNN memang sangat baik mengenali pola visual seperti garis, bentuk, atau karakter, karena kemampuannya melakukan konvolusi pada gambar. Di text recognition, CNN dipakai di tahap awal untuk mengekstrak fitur visual dari gambar teks — jadi tugasnya "melihat", bukan "membaca urutan".
Masalahnya, teks itu bukan cuma soal mengenali satu karakter. Teks adalah urutan karakter yang punya makna kalau dibaca berurutan. CNN sendiri nggak punya konsep "urutan" — dia cuma tahu bentuk di suatu lokasi gambar itu mirip apa.
Peran LSTM: Memahami Urutan
Di sinilah LSTM (Long Short-Term Memory) masuk. Sebagai jenis RNN (Recurrent Neural Network), LSTM dirancang untuk memahami urutan data dan mempertahankan konteks dari satu timestep ke timestep berikutnya.
Setelah CNN mengekstrak fitur-fitur visual, LSTM memproses urutan informasi fitur ini. Dalam text recognition, ini penting karena LSTM bisa menangkap urutan karakter dengan memperhatikan hubungan temporal atau spasial di antara mereka — membantu model "membaca" teks secara berurutan dari kiri ke kanan (atau sebaliknya, tergantung bahasa).
Gabungan CNN (ekstraksi fitur) + LSTM (pemahaman urutan) inilah yang sering disebut arsitektur CRNN: model yang mampu menangani text recognition dengan akurasi tinggi, khususnya untuk teks yang terdistorsi atau tidak beraturan.
Masalah Alignment dan Kenapa Butuh CTC Loss
Nah, ada satu masalah teknis yang belum kejawab: gambar teks itu diproses per "potongan" waktu (timestep) oleh LSTM, tapi panjang urutan yang diprediksi model sering kali berbeda dari panjang teks yang sebenarnya. Nggak ada segmentasi eksplisit yang bilang "piksel ini sampai piksel ini adalah karakter pertama".
Di sinilah CTC (Connectionist Temporal Classification) Loss berperan. CTC dirancang khusus untuk menangani tugas pengenalan urutan yang tidak sejajar — dia memperhitungkan semua kemungkinan cara untuk menyelaraskan urutan prediksi ke teks yang benar.
Contohnya, kalau sistem memprediksi lebih banyak karakter daripada yang ada di teks asli, CTC akan mengabaikan prediksi yang berlebih dan mencari urutan yang paling masuk akal yang cocok dengan teks yang benar. CTC juga memungkinkan pengenalan karakter langsung tanpa perlu label per frame/timestep — jadi sistem bisa "menebak" bagian gambar mana yang sesuai dengan karakter tertentu di teks.
Dari Materi ke Kode: Membangun CRNN
Materi di atas itu konsep. Sekarang bagian yang saya suka: benar-benar membangunnya jadi kode dan menjalankannya.
Dataset. Karena nggak ada dataset "urutan multi-digit" siap pakai, saya bikin sintetis dari MNIST: 5 gambar digit MNIST acak digabung horizontal jadi satu gambar [1, 28, 140], dengan urutan digitnya jadi label (misal gambar → label "59714").
Arsitektur. Persis mengikuti pembagian tugas di materi:
Input [B, 1, 28, 140]
  → Conv2d(1, 64) + ReLU + MaxPool      ← ekstraksi fitur (CNN)
  → Conv2d(64, 128) + ReLU + MaxPool
  → reshape ke urutan
  → BiLSTM(hidden=128, bidirectional)   ← pemahaman urutan (LSTM)
  → Linear(256, 11)                     ← 10 digit + 1 blank untuk CTC
  → log_softmax
Training. nn.CTCLoss(blank=10) dengan optimizer Adam (lr=1e-3), dijalankan di Google Colab dengan GPU.
Hasil Training
Ini bagian yang saya pegang teguh: setiap angka di bawah ini saya ambil dari run Colab yang benar-benar saya jalankan, bukan estimasi. Kali ini juga ada held-out test set asli — 2.000 sequence yang dibuat dari test split MNIST sendiri, jadi benar-benar gambar yang belum pernah dilihat model saat training.
| Epoch | Train Loss | Test Loss (held-out) |
|---|---|---|
| 1 | 2.0011 | 0.5838 |
| 2 | 0.3011 | 0.1850 |
| 3 | 0.1380 | 0.1102 |
| 4 | 0.0867 | 0.0765 |
| 5 | 0.0599 | 0.0732 |
| 6 | 0.0431 | 0.0590 |
| 7 | 0.0308 | 0.0472 |
| 8 | 0.0242 | 0.0432 |
| 9 | 0.0171 | 0.0409 |
| 10 | 0.0138 | 0.0437 |
Dihitung juga secara kuantitatif di seluruh 2.000 sequence held-out itu:
| Metrik | Nilai |
|---|---|
| Sequence accuracy (exact match) | 93.45% |
| Character Error Rate (CER) | 1.37% |
Cek kualitatif pada satu sampel acak dari held-out test set:
Target   : 94653
Prediksi : 94653
Cocok persis, dan kali ini didukung angka akurasi menyeluruh di belakangnya — bukan cuma satu sampel doang.
Plot Twist: Yang Ketauan Pas Iseng Ngecek Ulang
Satu hal yang jujur perlu saya sampaikan dari versi pertama tulisan ini, bukan cuma dipajang angka bagusnya doang: waktu itu saya belum menghitung akurasi menyeluruh atau character error rate (CER) — cuma modal satu sampel cocok, dianggap selesai.
Saya perbaiki itu: bikin test_dataset terpisah asli dari MNIST test split, hitung train loss vs test loss tiap epoch (biar ketauan kalau modelnya mulai overfitting), dan tambahkan evaluasi kuantitatif (sequence accuracy + CER) di seluruh held-out set. Hasilnya jauh lebih meyakinkan: 93.45% exact match dan CER cuma 1.37%.
Satu hal yang tetap saya jaga jujur: test loss-nya sedikit naik dari epoch 9 (0.0409) ke epoch 10 (0.0437), sementara train loss terus turun — tanda awal overfitting ringan. Nggak fatal, tapi saya nggak nutup-nutupin. Angka akurasi di atas tetap saya hitung dari bobot epoch terakhir (epoch 10), bukan dari checkpoint yang mungkin sedikit lebih baik di epoch 9.
Tiga Pendekatan, Tiga Cerita
Materi sesi ini sebenarnya membuka pintu ke beberapa cara berbeda buat "membaca" teks dari gambar. Selain CRNN + CTC yang dibahas di sini, saya juga coba dua pendekatan lain sebagai perbandingan — masing-masing akan saya bahas lebih dalam di tulisan terpisah.
| Pendekatan | Tipe tugas | Butuh training? | Kapan cocok dipakai |
|---|---|---|---|
| CRNN + CTC (tulisan ini) | Pengenalan urutan karakter | Ya, dari nol | Saat urutan karakter dan panjangnya bervariasi, tanpa segmentasi eksplisit |
| CNN classifier | Klasifikasi karakter tunggal | Ya, dari nol | Saat karakter sudah tersegmentasi rapi satu-satu |
| Vision-language model (VLM) | Ekstraksi teks via prompt | Tidak, pakai model pretrained | Saat butuh solusi cepat tanpa melatih model sendiri |
Kuis Kecil
1. Kenapa CNN saja tidak cukup untuk text recognition? A. Karena CNN terlalu lambat B. Karena CNN tidak punya konsep urutan/temporal C. Karena CNN tidak bisa memproses gambar hitam-putih D. Karena CNN butuh dataset yang sangat besar
Jawaban: B. CNN unggul mengekstrak fitur visual, tapi tidak dirancang untuk memahami urutan — itu tugas LSTM.
2. Apa masalah utama yang diselesaikan CTC Loss? A. Gambar yang terlalu gelap B. Model yang terlalu besar untuk di-deploy C. Ketidaksesuaian panjang antara urutan prediksi dan label asli D. Dataset yang tidak seimbang
Jawaban: C. CTC menyelaraskan urutan prediksi (yang panjangnya bisa berbeda-beda) ke label teks yang benar, tanpa perlu segmentasi karakter eksplisit.
Ringkasan
[x] Text recognition (OCR) mengekstrak teks dari gambar/dokumen ke data digital
[x] CNN bertugas ekstraksi fitur visual, LSTM bertugas memahami urutan — gabungannya disebut CRNN
[x] CTC Loss menyelaraskan panjang prediksi yang tidak sejajar dengan label, tanpa segmentasi eksplisit
[x] Dataset Sequence-MNIST sintetis dipakai karena tidak ada dataset urutan multi-digit siap pakai
[x] Training 10 epoch terverifikasi di held-out test set asli (2.000 sequence dari MNIST test split)
[x] Sequence accuracy 93.45%, Character Error Rate 1.37% — bukan lagi cuma satu sampel cocok
Kode lengkapnya bisa dicek di repo GitHub text-recognition-crnn-ctc. Dua pendekatan lain yang saya singgung di atas — CNN classifier dan VLM-based OCR — akan saya tulis di post terpisah.