Semantic Segmentation dengan U-Net: Melabeli Setiap Piksel di Jalanan CARLA
Kalau object detection cuma kasih kotak di sekitar objek, semantic segmentation naik satu level: setiap piksel di gambar dikasih label kelasnya sendiri, sampai ke detail "piksel ini bagian dari mobil, piksel sebelahnya bagian dari jalan, piksel di atasnya langit". Precision-nya jauh lebih detail, dan itu sebabnya teknik ini yang dipakai di balik sistem mobil otonom buat "memahami" jalan, atau di citra medis buat menandai batas organ dan tumor sampai ke piksel.
Post ini nyeritain proses membangun U-Net dari nol buat segmentasi 13 kelas objek jalanan pakai dataset simulasi CARLA, dari arsitektur, training 200 epoch, satu bug yang sempat bikin bingung pas testing, sampai deploy lewat FastAPI.
Coba tebak dulu: kalau model segmentasi ini dapat Dice Score 0.95+ pas training, menurutmu hasil visualnya otomatis udah bagus? Simpan dulu jawabanmu, nanti dijawab di bagian Plot Twist.
Daftar isi
Semantic segmentation vs object detection
Tiga istilah ini sering ketuker, jadi disamakan dulu persepsinya:
| Task | Output | Granularitas |
|---|---|---|
| Object detection | Bounding box + label | Per objek |
| Semantic segmentation | Mask per kelas | Per piksel, kelas yang sama digabung jadi satu blob |
| Instance segmentation | Mask per instance | Per piksel, tiap instance dipisah walau kelasnya sama |
Semantic segmentation nggak peduli ada berapa mobil di gambar, semua piksel mobil dapat label "mobil" yang sama. Kalau butuh bedain "mobil A" dari "mobil B" secara individual, itu baru masuk ranah instance segmentation.
Kenapa U-Net
U-Net awalnya didesain buat segmentasi citra medis (makanya efisien walau data latihnya sedikit), tapi strukturnya cukup general dipakai di banyak domain lain, termasuk jalanan simulasi CARLA yang saya pakai di sini.
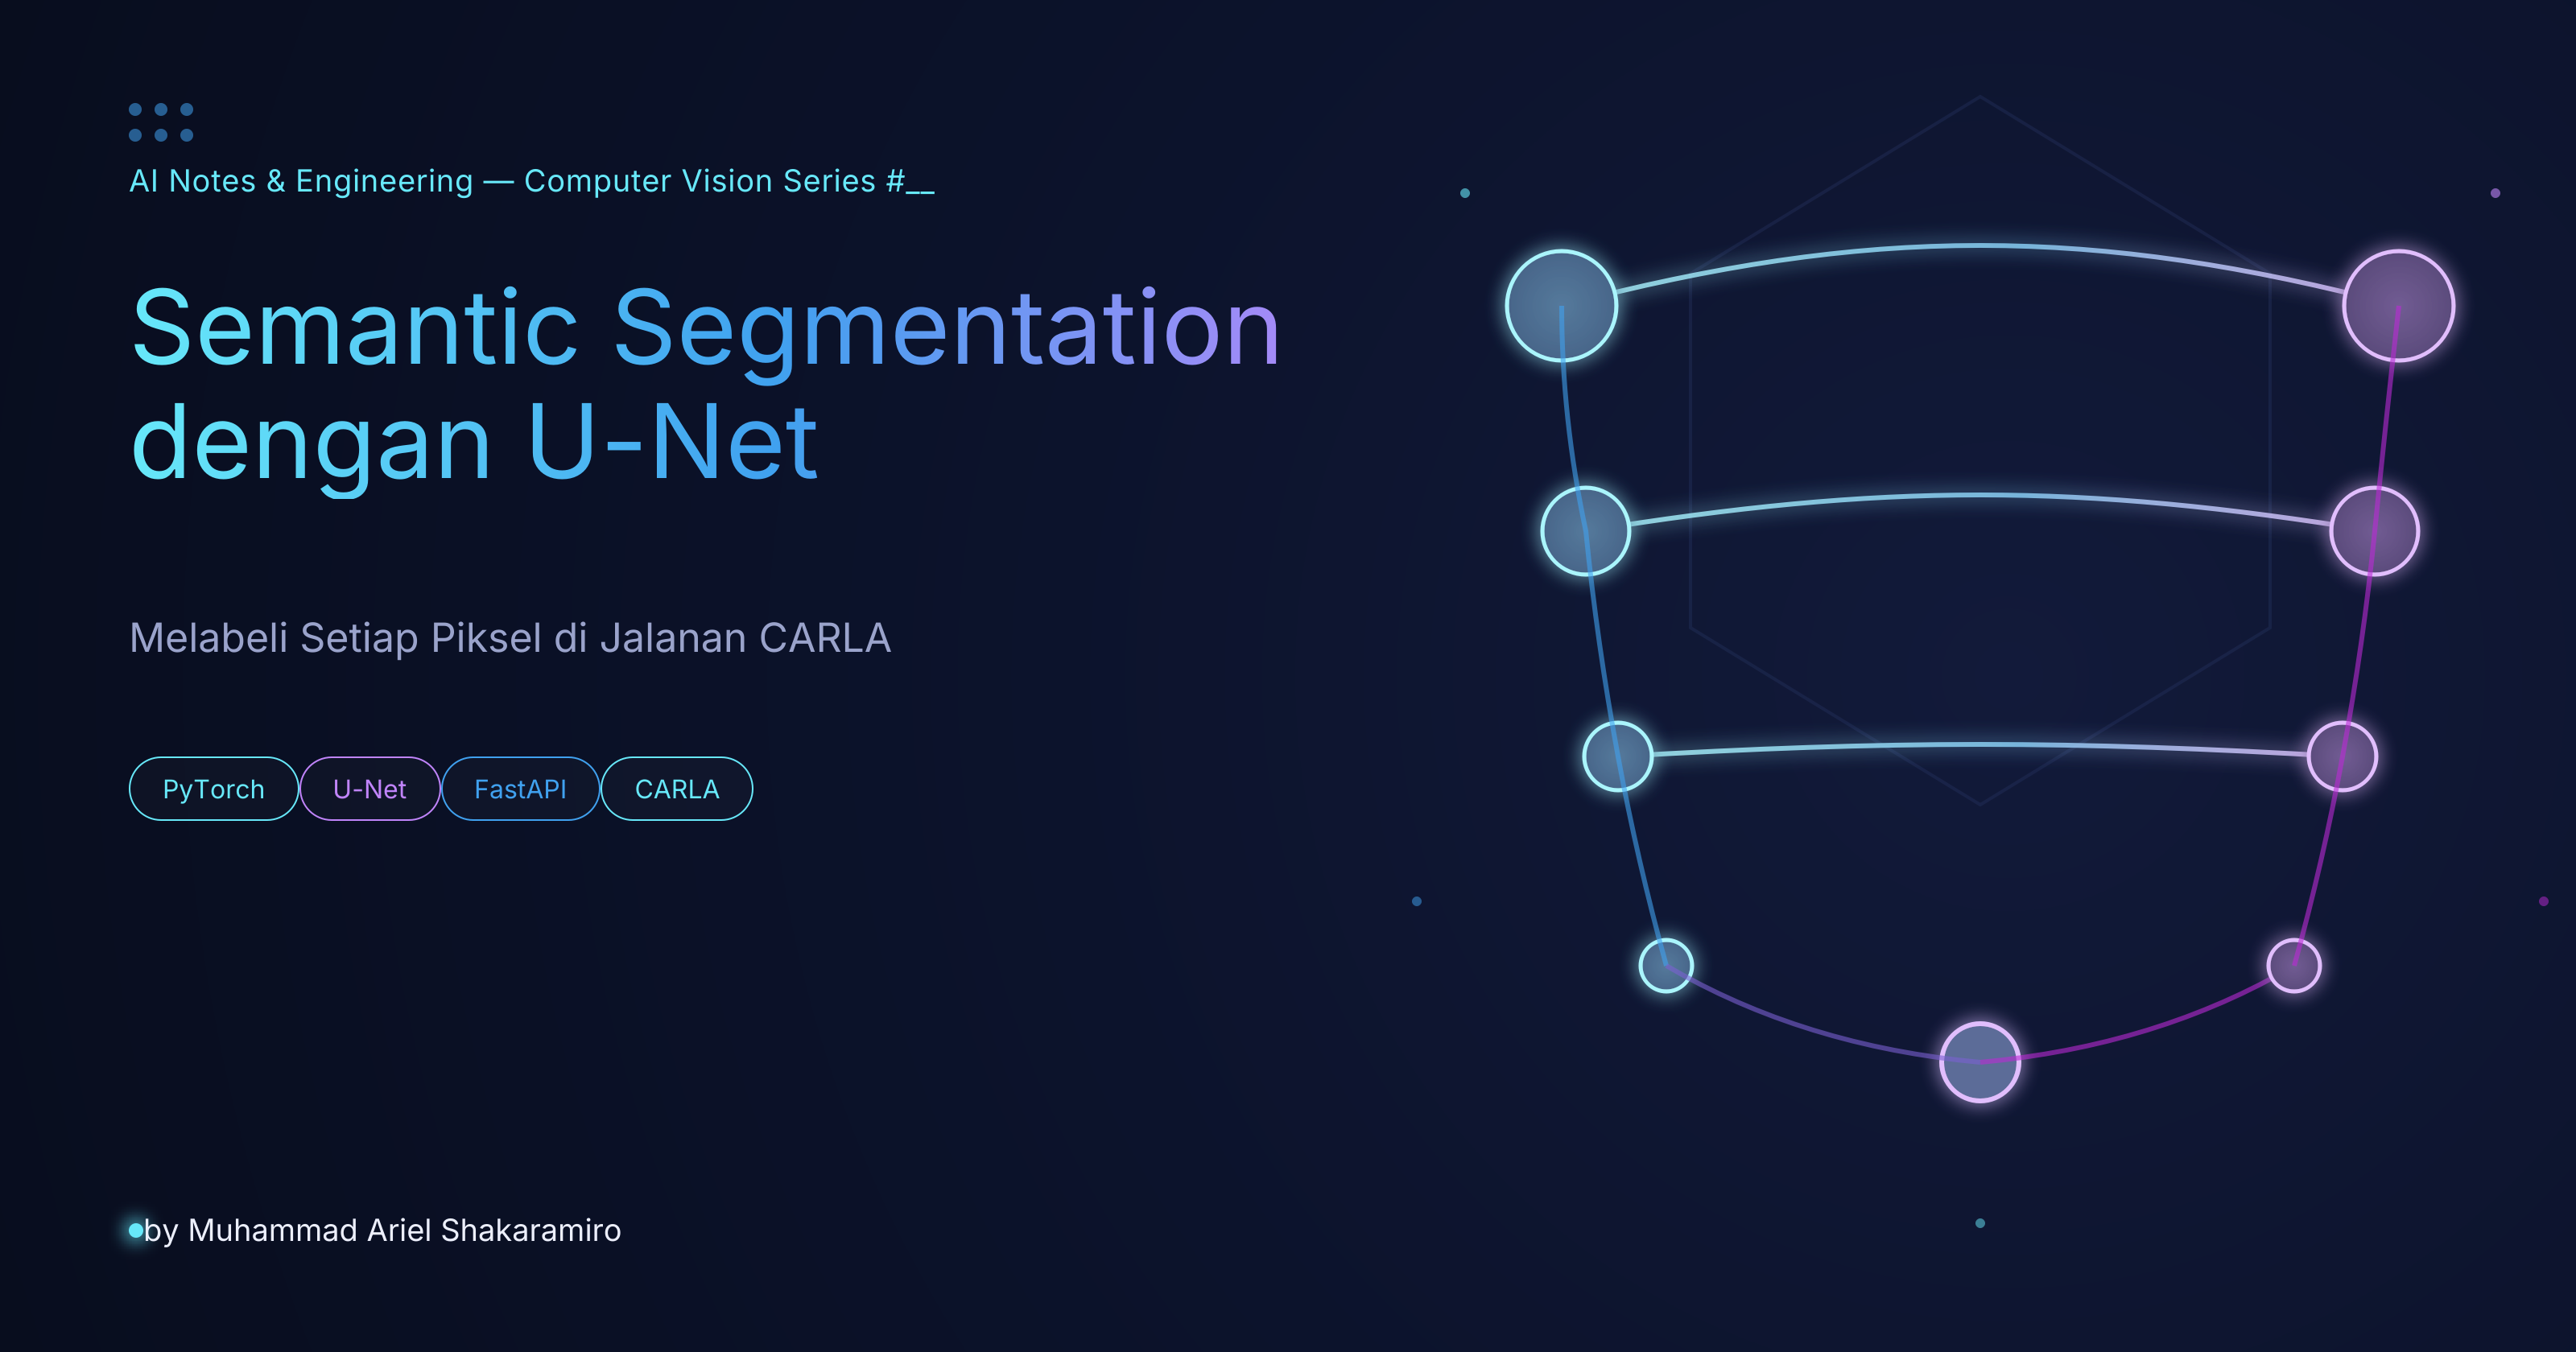
Bentuknya, sesuai namanya, kayak huruf U:
Contracting path (downsampling): serangkaian convolution + max pooling, gambar makin kecil tapi makin "dalam" (jumlah channel makin banyak). Bagian ini yang nangkep fitur-fitur abstrak.
Bottleneck: titik paling sempit di tengah, representasi paling terkompresi dari gambar.
Expansive path (upsampling): transposed convolution buat memperbesar ukuran kembali ke resolusi asli.
Skip connection: ini yang bikin U-Net beda dari encoder-decoder biasa. Fitur dari contracting path di-concat langsung ke expansive path pada resolusi yang sama, supaya detail spasial yang hilang pas downsampling nggak sepenuhnya hilang pas upsampling.
Tanpa skip connection, upsampling cuma bisa "menebak" bentuk detail dari representasi yang udah sangat terkompresi di bottleneck. Hasilnya biasanya blur di batas-batas objek. Skip connection kasih jalan pintas buat detail resolusi tinggi supaya batas objek tetap tajam.
Dataset dan setup
Dataset: CARLA capture dataset (
carla-capture-20180513A.zip), 1.000 pasang gambar RGB + label segmentasi, 13 kelas (jalan, mobil, pohon, langit/unlabeled, dan lainnya).Ukuran gambar: di-resize ke 256×256.
Split: 800 train / 200 test (80/20).
Loss: Multiclass Dice Loss.
Metrik: Dice Score, dihitung per keseluruhan dataset (bukan rata-rata kasar per-batch).
Training dan hasil
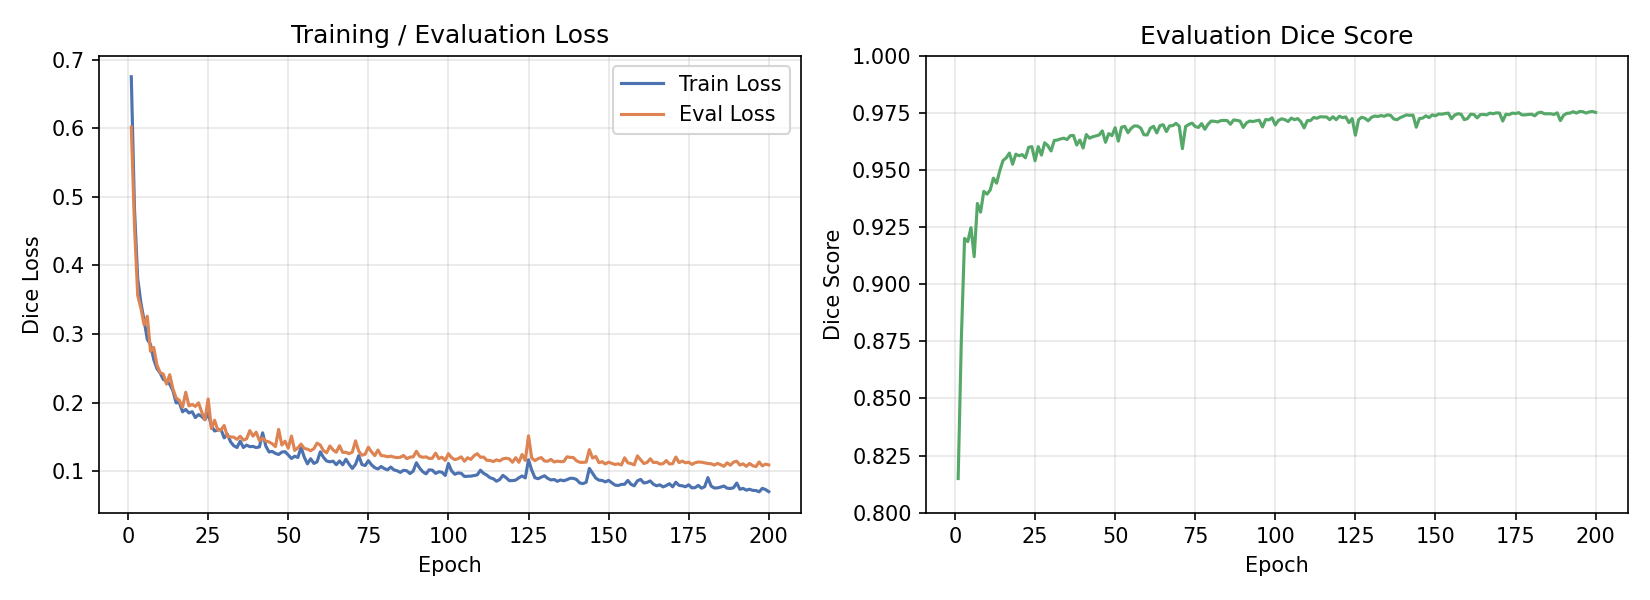
Training jalan penuh 200 epoch di Colab (GPU). Dice Score naik dari ~0.81 di epoch pertama, konvergen ke ~0.975 di epoch-epoch akhir:
| Epoch | 200 |
| Checkpoint terbaik | epoch ke-196 |
| Eval loss (terbaik) | 0.1068 |
| Dice Score (terbaik) | 0.9756 |
Angka-angka ini diambil langsung dari log training yang beneran jalan, bukan estimasi dari slide materi.
Plot twist: mask hitam polos
Nah, ini bagian yang jadi alasan post ini ditulis dengan judul yang agak dramatis.
Begitu training selesai dengan Dice Score 0.95-an, wajar dong kalau ngira hasil segmentasinya bakal langsung kelihatan bagus pas divisualisasikan. Tapi begitu di-plot, hasilnya mask hitam polos. Nggak ada satu pun piksel yang ke-label.
Setelah ditelusuri, akar masalahnya ada di kode postprocessing, model-nya sendiri baik-baik saja. Awalnya, output model (softmax probability per kelas) diubah jadi mask pakai threshold tetap: piksel dianggap "kelas ini" cuma kalau probabilitasnya di atas 0.6. Kedengarannya masuk akal, tapi buat kasus 13 kelas, distribusi probabilitas antar kelas sering nggak ada yang setinggi 0.6 di satu piksel manapun, apalagi di awal-awal training. Hasilnya, hampir semua piksel gagal lolos threshold dan default ke background.
| Pendekatan | Cara kerja | Masalah |
|---|---|---|
Threshold tetap (prob >= 0.6) |
Piksel dianggap kelas tsb kalau probabilitasnya lewat ambang batas | Bisa nggak ada kelas yang lolos sama sekali di satu piksel → default ke background |
| Argmax per piksel | Ambil kelas dengan probabilitas tertinggi, apa pun nilainya | Selalu dapat tepat satu kelas per piksel, deterministik |
Fix-nya sederhana: ganti threshold manual jadi torch.argmax() per piksel. Ini juga yang secara implisit diasumsikan sama metrik Dice Score yang dipakai buat evaluasi tadi, jadi sekalian menyamakan logika antara training dan inference.
Hasil setelah fix:
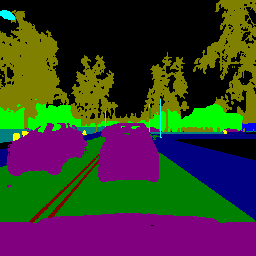
Jalan, mobil, pohon, semua kebentuk dengan jelas mengikuti kontur gambar aslinya. Jadi jawaban dari pertanyaan "coba tebak dulu" di awal: Dice Score bagus pas training nggak otomatis berarti pipeline end-to-end-nya udah benar. Angka metrik dan hasil visual itu dua hal yang tetap perlu dicek terpisah.
Serving lewat FastAPI
Model yang udah jadi di-deploy lewat FastAPI, di-expose ke publik pakai ngrok buat testing cepat tanpa perlu setup server permanen. Endpoint /segment-image/ nerima upload gambar, jalanin inference, terus balikin mask hasil segmentasi dalam format base64.
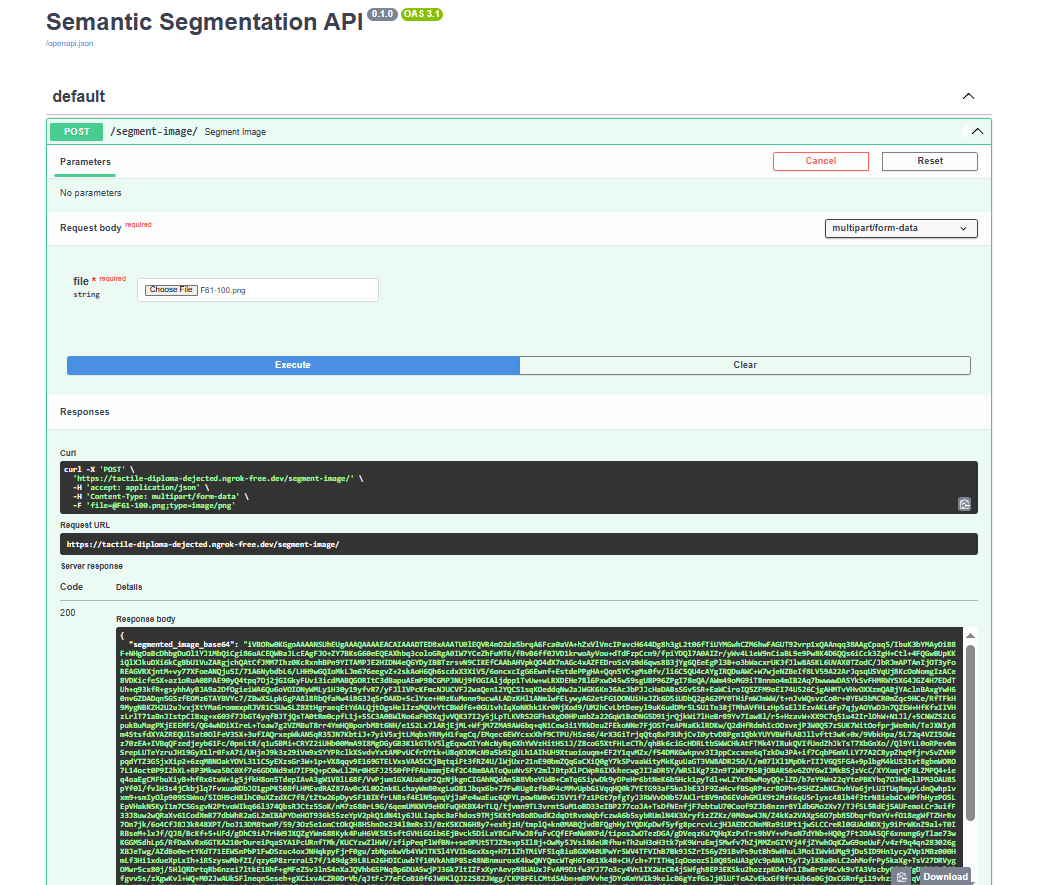
Satu catatan kecil soal keamanan: token auth ngrok itu credential yang gampang ke-expose kalau ditulis langsung di notebook. Praktik yang lebih aman adalah simpan di Colab Secrets atau environment variable, bukan hardcoded di kode yang berpotensi ikut ke-commit ke repo publik.
Kuis kilat
1. Apa fungsi utama skip connection di U-Net?
a) Mempercepat training
b) Mengurangi jumlah parameter
c) Membawa detail spasial resolusi tinggi dari contracting path ke expansive path
d) Mengganti fungsi bottleneck
Jawaban: c. Fungsi utamanya menjaga detail spasial yang biasanya hilang selama downsampling, supaya batas objek di hasil akhir tetap tajam. Kecepatan training dan jumlah parameter bukan hal yang jadi tujuan skip connection.
2. Kenapa Dice Score tinggi pas training nggak selalu berarti hasil visualnya benar?
a) Dice Score cuma dihitung di data training, bukan test
b) Metrik dan langkah postprocessing bisa punya asumsi input yang berbeda, jadi bisa "sepakat" secara angka tapi mismatch pas benar-benar dipakai
c) Dice Score nggak relevan buat segmentasi
d) Model selalu overfitting kalau Dice Score tinggi
Jawaban: b. Ini persis yang terjadi di kasus threshold vs argmax di atas: metrik evaluasi menghitung dengan asumsi tertentu, sementara kode postprocessing yang dipakai buat visualisasi/serving pakai asumsi lain.
3. Dalam semantic segmentation, dua mobil yang bertampalan dalam satu gambar akan...
a) Selalu dipisah jadi dua mask berbeda
b) Digabung jadi satu blob mask dengan label kelas yang sama
c) Salah satunya otomatis diabaikan
d) Butuh model terpisah untuk masing-masing
Jawaban: b. Itu bedanya sama instance segmentation. Semantic segmentation cuma peduli kelasnya, bukan instance-nya.
Ringkasan
[x] Semantic segmentation melabeli tiap piksel, beda dengan object detection yang cuma kasih bounding box
[x] U-Net punya tiga bagian utama: contracting path, bottleneck, expansive path, plus skip connection sebagai ciri khasnya
[x] Training 200 epoch di dataset CARLA (1.000 gambar, 13 kelas) konvergen ke Dice Score 0.9756
[x] Dice Score yang bagus nggak otomatis menjamin output visual benar, karena metrik dan postprocessing bisa punya asumsi format input yang beda
[x] Threshold manual diganti argmax per piksel buat postprocessing yang deterministik
[x] Model di-deploy lewat FastAPI + ngrok, dengan catatan keamanan soal auth token
Source code lengkap (training + serving notebook, README, hasil verified) ada di GitHub: github.com/arielshakaramiro/semantic-segmentation-unet
Bagian dari seri Computer Vision di AI Notes & Engineering.